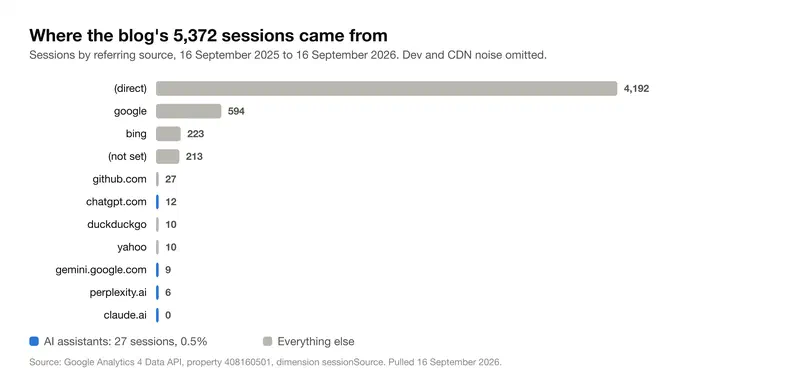
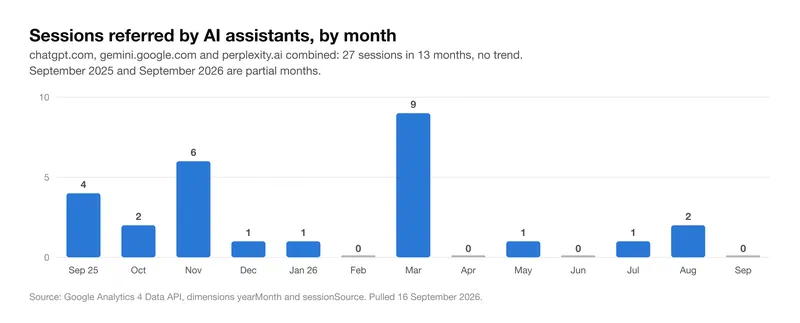
このブログへの検索流入はここ2年ほど横ばいで、動くことを期待するのはやめました。そこで代わりに、訪問者がどこから来ているのか、その中にAIアシスタントはいるのかを見に行きました。いることはいます。かろうじて、ですが。2026年9月16日までの12か月で、Analyticsが数えたこのサイトのセッションは5,372。そのうちAIアシスタント経由は27で、内訳はchatgpt.comから12、gemini.google.comから9、Perplexityから6、claude.aiからは0でした。0.5%です。ただ、ChatGPTから来た人は良い訪問者でした。平均の滞在時間は5分。直接アクセスの27秒、Google経由の3分と比べると長い。すでに答えを読んだうえで、詳細を知りたくて来ているからです。
そこで、小さなブログがそういう回答の情報源に選ばれるにはどうすればいいのか、少し時間をかけて調べました。この記事はこのサイトでやったことと、それについてログが何を言っているかの話です。数字があるところは数字を出し、推測でしかないところはそう書きます。最初の草稿にあった3つの文は、実際に調べてみたら間違っていました。その訂正はそのまま残してあります。
ボットは2種類あって、引用してくれるのは片方だけ#
まずはっきりさせておきたいのは、「AIボット」と呼ばれるものは仕事の違う2種類で、ユーザーエージェントも別、片方をブロックしてももう片方には何の影響もない、ということです。
学習用クローラーは、次のモデルを作るためにページを大量に持っていきます。OpenAIのはGPTBot、AnthropicのはClaudeBot、GoogleのはGoogle-Extendedというトークンで、AppleのはApplebot-Extendedで制御し、Common CrawlのCCBotは公開データセットの大半の元になっています。持っていかれたものは重みになって終わりで、こちらへのリンクは残りません。これらをブロックする理屈はあって、私も馬鹿げた話だとは思いません。
もう一方が検索取得用のボットです。誰かがChatGPTやClaudeやPerplexityに質問すると、アシスタントは検索を走らせ、その場で数ページを取得して読み、出典付きで答えを書きます。その取得はOAI-SearchBotとChatGPT-User、Claude-SearchBotとClaude-User、PerplexityBotとPerplexity-Userとして届きます。GoogleのAI Overviewsは普通のGooglebotを使うので、専用のスイッチはそもそも存在しません。訪問者を送り返してくれるのはこちらのボットです。引用されるのが目的なら最適化する相手はこちらで、GPTBotをブロックしてもChatGPTの検索結果には良くも悪くも何の影響もない、というのは知っておく価値があります。
このサイトのrobots.txtはHugoのデフォルトで、すべて許可です:
User-agent: *
Allow: /
Sitemap: https://jared.lynskey.co.nz/sitemap.xml分けることも考えました。取得用のボットは通し、学習用は締め出す。でも、読まれることがそもそもの目的のブログでやる価値はないと判断しました。もしやるなら下のようになります。あえて載せるのは、Cloudflare が Googlebot に空のページを返していたと同じ教訓があるからです。一覧に書くのはボット名であって、会社名ではありません。「OpenAI」と書ける行は存在しないのです。
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: CCBot
Disallow: /

User-agent: *
Allow: /
サイトがCloudflareの後ろにあるなら、確認しておくことが1つあります。2025年半ば以降、新しいゾーンはデフォルトでAIクローラーをブロックしますし、ボット設定には既存のゾーンにワンクリックで同じことをするトグルがあります。これは両方の種類をブロックします。このブログは先週Cloudflare Pagesに移したので、私の確認リストにも入っていました。「AIボット」というのが締め出すべきものに聞こえて有効にしたのなら、引用も一緒に切ってしまっています。その後Cloudflareは、管理しているrobots.txtにContent-Signalの行を書き込むようになりました。search、ai-input、ai-trainという別々のフラグを持つものです。誰も従う義務はありませんが、語彙としては正しいと思います。上と同じ区分を、壁ではなく希望として表現したものです。
実際にドアを叩いているのは誰か#
Cloudflareへの移行には副作用がありました。初めて、すべてのリクエストをユーザーエージェント別に見られるようになったのです。2026年9月13日から16日までの4日間に来たものを、偽物を除いたうえで並べたのが下の表です。偽物についてはあとで書きます。
| ボット | リクエスト数 | やったこと |
|---|---|---|
| ClaudeBot(学習用) | 1,777 | 2日間で1,380の異なるページ、5言語すべて、加えてrobots.txtを37回 |
| meta-externalagent(学習用) | 1,748 | 同じことを、1日遅れで |
| OAI-SearchBot(ChatGPTの検索インデックス) | 59 | 5言語すべてのページと、robots.txtを16回 |
| ChatGPT-User(回答中に取得) | 20 | Fly.ioのコールドスタートの日本語記事、Expoのアップデートサーバーの記事、トップページ |
| Claude-User(回答中に取得) | 8 | アップデートサーバーの記事、contactページ、トップページ |
| PerplexityBot | 2 | iOSデバッグの記事、英語版とベトナム語版 |
| Claude-SearchBot、Perplexity-User | 0 | |
| Googlebot / Bingbot / Applebot / CCBot | 168 / 71 / 45 / 28 |
目を引くことが2つあります。学習用クローラーは、取得用ボットが数十ページを読むあいだに、すべてを2回読んでいます。そして取得用ボットは手当たり次第に取っているわけではありません。ChatGPT-UserもClaude-Userも、このサイトでいちばん具体的な記事であるアップデートサーバーの記事を取りに来ていて、コールドスタートの記事は日本語版が取得されています。
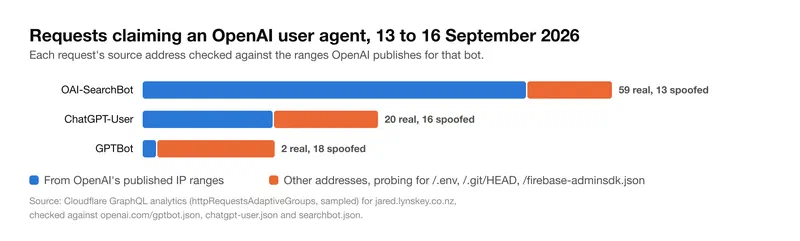
次に偽物の話です。GPTBotを名乗るリクエスト20件のうち18件は、OpenAIが公開しているIPレンジの外から来ていて、/.env、/.git/HEAD、/firebase-adminsdk.jsonを要求していました。「ChatGPT-User」を名乗る36件のうち15件も同じ類のものです。「PerplexityBot」のトラフィックは大半が/id_ed25519を欲しがっていました。ユーザーエージェントは誰でも送れるただの文字列で、脆弱性スキャナーはAIボットの名前なら素通しされることに気づいています。OpenAI、Anthropic、PerplexityはいずれもIPレンジを公開しています。ボットを特別扱いするなら、通すにせよ止めるにせよ、名前ではなくアドレスを確認すること。上の20、59、8は、正しいアドレスから来たリクエストの数です。
ページはブラウザなしで読めなければならない#
取得用のボットは回答時にタイムアウト付きで取りに来て、ほとんどはJavaScriptを実行しません。バンドルが読み込まれるまで空のdivでしかないページは、彼らには読めないページです。Hugoは完成したHTMLを書き出すので、このブログはそれをただで手に入れていて、もっと凝ったものに移そうと思ったことが一度もない最大の理由がこれです。私が運営しているマーケットプレイスはその正反対で、React NativeのWebアプリです。あそこでクローラーに本物のドキュメントを渡すには動的レンダリングの分岐が必要で、そのあとキャッシュのバグがそれを静かに台無しにしました。上のCloudflareの記事がその話です。
速度も同じように効きます。そしてここでは、ログに間違いを正されました。Cloudflareの後ろにある静的サイトは、いちばん近いエッジから配信されるものだと思い込んでいました。そうではありませんでした。このブログはCloudflare Pagesにあって、HTMLはキャッシュされずに出ていき、ソウルからだとロサンゼルスから0.5秒ほどで返ってきます。数秒のタイムアウトを持つボットにはそれでも十分ですが、私が言い張っていたであろう数十ミリ秒ではありませんし、それが分かったのは測ったからです。6ページから答えを組み立てているアシスタントは、3秒かかるページを落とします。落としたとは教えてくれません。
段落をそのまま切り出せるように書く#
こうしたシステムのページの使い方は、読者の読み方とは違います。ページをチャンクに分け、質問に対して各チャンクを採点し、点の高いものを引用します。800語かけて結論に向かっていく記事は、どのチャンクでも点が低い。各セクションが最初の文で主張を述べてから裏付ける記事は、質問に合ったセクションで点を取ります。
これは、どんな技術的なことよりも、ここでの書き方を変えました。フロントマターのdescriptionは今、読ませるためのフックではなく、記事が何を言っているかの要約です。アシスタントが見せるのはdescriptionだけ、ということがよくあるからです。セクションの見出しは、そのセクションの結論を書く。数字はグラフではなく、単位と一緒に文の中に入れる。日付は書き出す。1年後にページを読むモデルにとって「先週」は何の意味もないからです。そして、1本の記事は1つのことについて書く。
もう半分は、引用する価値のある何かを持っていることで、ここはデータが割れています。ログを見ると、回答時のボットが取得するのは具体的な記事です。Fly.ioのコールドスタート、アップデートサーバー、iOSのデバッグ。Naverのクローラーの名前はYetiで、DaumのはDaumoa。Fly.ioの再起動は504が出る30秒の窓。CloudflareのオンザフライのBrotli圧縮は、私のバンドルではgzipより悪い数字だった。こういう事実は書かれている場所が少ないので、それを必要とする質問はここに着地します。ところが、アシスタントからクリックして来る人の大半が着地するのは、2023年と2024年のマネジメントについての記事で、それぞれ1、2セッションずつ。具体的な記事は機械に読まれ、一般的な記事はクリックされる。これにきれいな説明は持っていませんし、でっち上げるよりは、そのまま報告するほうがいい。効くところがあるとすれば、それでもやはり、今週自分が突き止めた、検索しても見つからなかった具体的なことを書き残すことです。機械が実際に読んでいるのはそれだと、ログが示しているからです。
誰が書いたかを言い、同じことを言い続ける#
ページを引用するかどうか決めているアシスタントがやっているのは、注意深い読者がやることと似ています。誰がいつ書いたのか、他に見つけたものすべてと矛盾しないか。このサイトでその仕組みを担っているのは、ほとんどテーマです。すべての記事に、著者、公開日、更新日を持つArticleの構造化データが付いていて、著者は同じGitHubとLinkedInのプロフィールへのリンクを持つPersonです。テンプレートの数行ですが、それが「あるページ」と「経歴のある名前の付いた人物によるページ」の違いです。
テーマがやってくれないのは一貫性です。aboutページ、llms.txt、LinkedInのプロフィール、すべての記事の先頭にある1行は、同じ人物を同じ職歴で説明しています。何かが変わればすべて変える。そうしないと、忘れた1つが間違っているものになります。細かい話に聞こえますが、あるページではエンジニアリングマネージャーで別のページではフリーランス、というのはまさに、モデルが言葉を濁したり、別の人を選んだりする種類の矛盾です。
更新日も正直でなければなりません。内容が変わったときに変わり、それ以外では触りません。新しく見せるために日付を上げるのは、一度は効いて、そのあとドメイン全体が割り引かれる類のことです。
llms.txt、そして誰も読んでいないという事実#
llms.txtは2024年9月に提案されたもので、サイトのルートに置くMarkdownファイルに、サイトの要約と厳選したリンクの一覧を書いて言語モデルに渡す、というものです。今年の2月に追加しました。私が誰かについての段落が1つ、そのあとマネジメント、インフラ、モバイル、コミュニティのセクションがあって、記事ごとに1行。タイトル、URL、そして記事の結論を述べた1文です。急いでいる人のために書いた目次のように読めます。
但し書きというのは、誰も読んでいない、ということです。手元にある4日分のログで/llms.txtへのリクエストは、自分のものだけでした。Common Crawlは2026年8月のクロールでこのサイトの76ページを取り込んでいますが、このファイルは一度もありません。主要なアシスタントで読むと表明しているところもない。つまり、ここの何かが引用される理由がこれだということはなく、その根拠で誰かに勧めるのはやめておきます。それでも残しているのには2つ理由があります。かかったのは1時間で、記事ごとに「この記事は実際に何を結論づけているか」を1文で書く作業のほうがファイルそのものより価値がありました。どの記事が何も結論づけていないかが分かったからです。それに、このサイトが何のためにあるかを機械に伝える唯一のページでもあり、必要にならなくても持っておきたい。手で書いていて忘れるので、その後ずれてきていて、それがHugoの出力フォーマットとしてフロントマターから生成すべきだという論拠になっています。やることリストには入っています。
フィード、サイトマップ、5つの言語#
地味な配管も相変わらず効きます。サイトマップは、クローラーが新しい記事を公開当日に見つける手段です。RSSは、記事が変わったことを知る手段。どちらもHugoのデフォルトで、考えたことがありません。ClaudeBotは2日間でサイトマップを36回読んでいて、1,380ページをあれだけ速く見つけられたのはそのためです。
言語は、重要だと思っていなかった部分です。ここにあるものはすべて英語、日本語、韓国語、簡体字中国語、ベトナム語で、同じ記事だとクローラーに分かるようalternateリンクが付いています。クローラーはこれを5つのサイトとして扱います。ClaudeBotのクロールは5言語にほぼ均等に割れていて、Common Crawlが8月に取り込んだ73の記事ページのうち、英語版は4つだけでした。アシスタントは聞かれた言語で答え、その言語の情報源に寄るので、Fly.ioのコールドスタートについての韓国語の質問は、英語ページをその場で翻訳したものではなく韓国語のページから答えられますし、ChatGPTが実際に取得したのは日本語のページでした。条件は、翻訳がその言語で書かれたもののように読めることです。今年の初めにネイティブスピーカーのチェックを入れてやった見直しは人間の読者のためでしたが、ベトナム語のページを珍しいものではなく情報源にしているのもそれです。
測れること#
推測をやめてみたら、思っていたより多くのことが測れました。Cloudflareの無料プランでは、ユーザーエージェントとパス別のリクエストログが1クエリにつき1日分見られて、ボットの表はそこから来ています。リファラを見るには有料プランが要ります。リファラはGoogle Analyticsにあって、ダッシュボードを目を細めて眺めるのではなくAPIで引き出したのが、冒頭の数字です。2つを合わせると全体の形が見えます。4日間で、取得用ボットはOpenAIとAnthropicのアドレスから90ページほどを取得しました。この1か月でChatGPTから来た人は2人。たくさん読まれ、ときどき引用され、めったにクリックされない。ページを使ったけれどクリックされなかった回答を見る方法は、相変わらず私の知るかぎりありません。いちばん役に立つ確認は今でも手作業です。記事が答えている質問をアシスタントに聞いて、誰のページを引用するか見る。
この中から1つだけ残すなら、書き方のルールです。robots.txtと構造化データとllms.txtは半日の作業で、終われば終わりです。各セクションが主張を最初に言うように書くこと、一般的なことではなく具体的なことを書くことは習慣で、ページに引用する価値があるかどうかを決めるのはその習慣です。2つ目は、主張する前に測ること。機械に信頼されるというのは、結局のところ人に信頼されるのとよく似ています。自分が誰かを言い、知っていることを言い、毎回同じように言う。