ひとつのアプリを作る小さなチームを思い浮かべてください。開発者は二人でも五人でも構いません。分野ごとの専門家ではなく、それぞれが自分のブランチで、データベースのマイグレーションから API を経てモバイルアプリの画面まで、機能をひとつ端から端まで受け持つ人たちです。チームの回し方としては良いやり方で、二人目の開発者が加わった瞬間から繰り返し起きる失敗がひとつあります。「今ステージング使ってる人いる?」というメッセージです。
そのメッセージの裏には、機能を作り終えてテスターやデザイナーに見せたいのに見せられない開発者がいます。ステージングには二人目の開発者のブランチが載っていて、dev には三人目のブランチが載っていて、そちらは二日前にログインを壊してから再デプロイされていません。数人、共有環境が二つ、そしてスケジュール調整を引き受けている Slack スレッド。
これは人の問題ではありません。トポロジーの問題です。全員が環境を「自分のブランチが本物になる場所」として扱っているので、環境がマージのやるべき仕事をブランチひとつずつ順番に肩代わりし、残りの全員が列に並んでいるのです。
自分のスタックの本番の形は My Current Stack に書きました。Fly.io の最安マシン上で Granian に載せた Django、PgBouncer の背後の Fly Postgres、キャッシュと Channels レイヤー用の Redis、別立ての WebSocket アプリ、バックグラウンドジョブ用の db_worker、ファイル用の Tigris、Firebase Auth、前段の Cloudflare、そしてそれら全部と話す Expo アプリです。この記事は、そのスタックを、どのブランチでも開発者が PR にラベルをひとつ付ければ数分のうちに HTTPS 付きの公開コピーを丸ごと手に入れられるものに変えた話です。他の誰かに頼むことも、誰かが用意してやることもありません。Postgres クラスタも Redis もバケットも、二つ目は用意しません。インフラは共有のままです。変わるのは、共有リソースのすべてが名前で切り分けられるようになることで、その名前はブランチから来ます。ここにチームの規模を前提にしたものはありません。開発者が二人でも二十人でも設計は同じで、増えるのはアプリの一覧だけ、それはスイーパーが面倒を見ます。作って、ブランチを三つ同時に動かして、予想していなかった二か所で壊して、片付けるまでを午後のうちに済ませました。以下の出力はその実行から取ったものです。
共有環境ひとつが開発者一人分より先に伸びない理由#
共有 dev 環境には前提がひとつ焼き込まれています。全員が見たがる「現在のコードのバージョン」がひとつだという前提です。開発者が一人のとき、あるいはチームが変更の流れをひとつ歩調を合わせて進めているときは正しい。二人目の開発者が別のスケジュールで機能に着手した瞬間に正しくなくなり、端から端までのオーナーシップではそれがすべての機能で起きます。それ以降、環境が抱えるものはすべて取り合いになります。
- デプロイされたコード。 最後にデプロイした人が勝ちます。残りの人の作業は再デプロイするまで見えず、再デプロイすれば前の人のものが消えます。
- データベースのスキーマ。 各開発者が自分の機能のデータモデルを持つとき、いちばん強く噛みつく部分です。最初のブランチがカラムを足す。一時間後にデプロイされた二つ目のブランチはそれを知らず、ORM が insert で失敗し始める。あるいは両方のブランチが
0042_*マイグレーションを持っていて、共有データベースが誰のマイグレーション履歴とも一致しない状態になり、誰かがリセットして、三人目が午後いっぱいかけて用意したテストデータを消す。 - キャッシュ。 あるブランチのシリアライザ変更が、別のブランチのコードが読むのと同じ Redis キーの下にキャッシュされる。そこから出てくるバグ報告は不可解で、一件ごとに午前中がつぶれます。
- サードパーティ連携。 OAuth コールバックがひとつ、Webhook URL がひとつ、プッシュ証明書がひとつ。誰のブランチがデプロイされていようと、そのブランチがイベントを受け取ります。
- テスター。 デプロイされているものしかテストできないので、機能が準備できた順ではなく、環境がたまたま確保された順に一度にひとつずつテストします。
チームは予約システムで応じます。Slack スレッド、ピン留めメッセージ、/claim staging ボット。それはロックです。作業を見せられる唯一の場所にかかったロックは、デリバリー速度にかかったロックです。開発者二人なら苛立つ程度です。三人なら良い週には耐えられます。四人目が加わるか、機能ひとつがデザイナーとの三日間のやり取りでステージングを握り続ければ、耐えられなくなります。
人が最初に手を伸ばす対処は三つ目の共有環境、「dev2」や「uat」です。数週間は稼げます。列が二車線になっただけです。
本当の対処は、dev もステージングもそもそも環境ではなかったと気づくことです。あれは 誰かのブランチの現在の状態に URL が付いたもの でした。それがそうなら、あるべき数は今チームが気にしているブランチの数で、あるべき寿命はブランチの寿命です。
モデル: ブランチが環境である#
目標の状態はこうです。
| 環境 | 数 | 作る主体 | 消す主体 | 寿命 |
|---|---|---|---|---|
| ブランチ環境 (かつての「dev」) | アクティブなブランチごとに一つ | ブランチの PR に付く env ラベル、その後は push のたびに。PR のないスパイクなら同じ ./scripts/env up を手で | ブランチ削除、そして毎晩のスイーパー | 数日 |
| ステージング | リリース候補ごとに一つ | main からタグが切られたときの CI | 同じイメージが本番に昇格したときの CI | 数時間 |
| 本番 | 一つ | あなたが、一度だけ | 誰も | 永遠 |
この表の、誰が作り誰が壊すかをもう一度見てください。どれも git のイベントか時計です。git がコントロールプレーンです。存在すべき環境の集合は存在するブランチの集合からそのまま決まり、自動化の仕事は現実をそれに合わせておくことだけです。PR のラベルが作り、その後の push のたびに更新し、PR を閉じるかマージすると壊し、毎晩のジョブが前の三つの取りこぼしを片付けます。すべてのブランチが環境を得るわけでもありません。ラベルがゲートで、開発者のクリックひとつなので、バックアップの push やボットの依存関係更新は費用ゼロです。誰も環境を用意しません。チケットを受けた DevOps エンジニアでも、Slack で呼ぶボットでも、毎回プロンプトを打つ AI エージェントでもありません。十人目の開発者の最初のブランチも、一人目のブランチとまったく同じやり方で、PR にラベルが付いたという理由で環境を得ます。人に頼まなければならないなら、それはスケールしたのではなく、行列の場所が変わっただけです。
そしてこれを成り立たせる規則はひとつです。環境が触れるすべてのリソースは、ブランチにちなんで決定論的に名付ける。 開発者名でもチケット番号でもなく、誰かが開くまで存在しない PR 番号でもありません。ブランチです。開発者が実際に扱うのがブランチだから、そして名前が決定論的なら、同じブランチで ./scripts/env up を二度目に実行したとき、新しい環境を作る代わりに既に作った環境を見つけられるからです。
名前は人のためのスラッグと、一意性のための短いハッシュです。
branch=$(git rev-parse --abbrev-ref HEAD)              # feature/payments-retry
slug=$(printf '%s' "$branch" | tr '[:upper:]/_ ' '[:lower:]---' | tr -cd 'a-z0-9-' | cut -c1-20)
hash=$(printf '%s' "$branch" | sha256sum | cut -c1-6)
ENV="${slug%-}-${hash}"                                 # feature-payments-retr-3f9a1c
feature-payments-retr-3f9a1c が環境です。この文字列が Fly アプリ名、Postgres データベース名(ハイフンはアンダースコアに)、Redis のキー接頭辞、Tigris のオブジェクト接頭辞、Sentry の environment、そしてホスト名の左端のラベルになります。ブランチ名を知っている人なら誰でも計算できます。どこかを引く必要はありません。
その最後の一文が設計です。環境の台帳もコーディネーターもありません。env up、env down、ホスト名をルーティングする Cloudflare Worker、毎晩のスイーパーが、それぞれ独立にブランチから名前を計算し直し、構造的に一致します。特に Cloudflare は何も調整していません。Worker はホスト名から Fly アプリへの純粋関数で、環境が作られたことも消されたことも知りません。アプリがあればリクエストは届き、なければ Fly が自分のエラーで答えます。
ここから三つのことが出てきます。
第一に、「ステージング誰が使ってる」が問いでなくなります。feature-payments-retr-3f9a1c-dev.marucommunity.com があり、fix-login-redirect-8b21e0-dev.marucommunity.com があり、それぞれそのブランチにいる人のものです。
第二に、ステージングがゴミ捨て場ではなく本番の正直なリハーサルになります。本番に行くまさにそのイメージで、数分前に本番の形のスナップショットから複製したデータベースを相手に組まれます。そこで動けば、本番に残る変数は本番のデータだけです。
第三に、各開発者が共有リソースの root を持たずに力を得ます。ブランチ環境の爆発半径はそのブランチ環境です。四人目の新人が初日に自分のブランチに何をデプロイしようと、最悪の結果は自分のブランチが壊れることです。
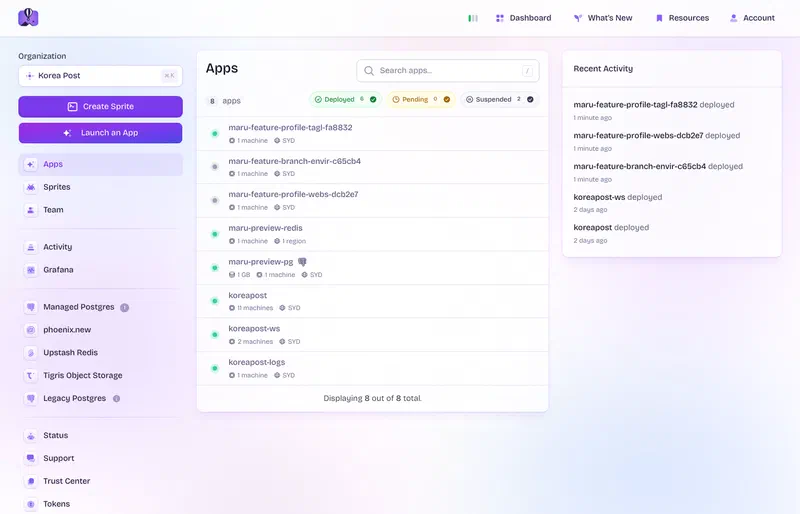
koreapost の行が本番です。物理的には共有、論理的には分離#
「ブランチごとに環境」の魅力的な版は丸ごとコピーです。Postgres クラスタをひとつずつ、Redis をひとつずつ、バケットをひとつずつ。きれいですが、悪い取引です。Fly Postgres クラスタはマシンひとつにボリュームひとつにリストア一回で、Redis はもうひとつのマシン。環境ごとに数分待ち、遊んでいるデータベース十数個分を払うことになります。スイーパーが片付ける種類も一つではなく四つになります。
代わりに、各共有サービスはプレビュー組織全体で一度だけ、小さな本番くらいのサイズで用意し、すべての環境が $ENV をキーにその一切れを受け取ります。壁に貼っておきたい表です。
| リソース | 共有されるもの | 環境ごとのもの | 強制する仕組み |
|---|---|---|---|
| コンピュート | Fly 組織 maru-preview | Fly アプリひとつ maru-$ENV、マシンひとつ | Fly: アプリが隔離の単位 |
| シークレット | Fly のアプリ別シークレットストア | アプリ自身のシークレット。SECRET_KEY、FIELD_KEY、ENV_TOKEN はコピーではなく環境ごとに生成 | Fly: シークレットはアプリに属し、マシンは自分のものしか読めない |
| Postgres | Fly Postgres クラスタひとつ maru-preview-pg | データベースひとつ env_feature_payments_retr_3f9a1c、seed_template から複製 | Postgres: データベースは固い境界、データベース間クエリは不可 |
| Redis | Upstash/Fly Redis ひとつ | キャッシュと Channels レイヤーにキー接頭辞 feature-payments-retr-3f9a1c: | Django KEY_PREFIX、channels_redis prefix |
| ファイル | Tigris バケットひとつ maru-preview | オブジェクト接頭辞 feature-payments-retr-3f9a1c/ | django-storages location; 署名付き URL は元からキー単位 |
| ホスト名 | ゾーンに既にあるプロキシ済み *.marucommunity.com レコード | 左端のラベル <env>-dev | *-dev.marucommunity.com/* の Cloudflare Worker ルート |
| 認証 | Firebase プロジェクトひとつ maru-dev | なし。ユーザーの identity は意図的に共有 (後述) | 承認済みドメイン marucommunity.com |
| エラーとログ | Sentry プロジェクトひとつ、Fly のログ | すべてに environment=$ENV タグ | 設定 |
このうち二つには一言添えておきます。
Postgres: スキーマではなくデータベース。 クラスタひとつを切り分けるもうひとつの方法は、環境ごとにスキーマを持ち、接続ごとに search_path を設定することです。接続の options に -c search_path=... を押し込めば Django もやってくれますが、トランザクションプーリングモードの PgBouncer は指示しない限り起動時オプションを捨てますし、そうすると結局プール内のすべての接続がひとつの環境に属さなければなりません。「なぜ自分のクエリが違うテーブルに当たるのか」系のバグの温床で、環境ごとにデータベースならそもそも存在しない問題です。データベースは固い境界で、CREATE DATABASE ... TEMPLATE は数秒でひとつ作り、DROP DATABASE は何も残さず消します。ブランチ環境は PgBouncer を通さず 5433 番ポートで Postgres に直接つなぎます。本番の db_worker と同じやり方です。プーラーは本番の同時実行数で元を取るもので、ブランチ環境がそれを見ることはありません。
シークレット: 共有ではなく生成。 dev 用シークレット一式を作って全環境にコピーすれば楽でしょう。やめましょう。env up スクリプトは環境ごとに新しい SECRET_KEY(セッション署名)、FIELD_KEY(保存時に暗号化するもの全部)、ENV_TOKEN(モバイルアプリが提示する bearer トークン、後述)を生成し、その Fly アプリのシークレットストアにだけ保存します。あるブランチのセッションクッキーは別のブランチでは無価値で、漏れたプレビュー用トークンが開くのはプレビューひとつだけで、開発者はわざわざ探さない限り値を見ることがありません。Fly だけでなく 1Password や Doppler のようなものにシークレットを置くなら、同じ規則が当てはまります。パスは maru/preview/$ENV/ で、スイーパーが環境と一緒にそのパスを消します。環境をまたいで本当に共有されるシークレットは共有インフラ自体の認証情報(Postgres の管理者 URL、Redis の URL、Tigris のキー)だけで、それらはどの環境でもなく CI に住んでいます。
Redis の行がいちばん疑いやすいので、試しました。ひとつの環境の中からキャッシュキーを入れ、もうひとつから読み、共有 Redis のすべてのキーを列挙します。
$ fly ssh console -a maru-feature-profile-tagl-fa8832 -C "python manage.py shell -c \"from django.core.cache import cache; cache.set('who-am-i','tagline-branch',600)\""
$ fly ssh console -a maru-feature-profile-webs-dcb2e7 -C "python manage.py shell -c \"from django.core.cache import cache; print(cache.get('who-am-i'))\""
None

$ # every key in the shared Redis, scanned from the website machine
  feature-profile-tagl-fa8832:1:who-am-i
  release:89112c88f7da008e:done
  ...
同じ Redis、同じキー名で、もう一方の環境からは何も見えません。(あの一覧の release:* キーは上で触れたリリースゲートのバグで、まさにこのスキャンで捕まりました。今は接頭辞の下にあります。)
この記事の残りは、あの八行に $ENV を刻印するスクリプトと、それを正直に保つ規則です。
./scripts/env up#
開発者が自分のブランチから実行するスクリプトとしての全体です。CI も同じスクリプトを実行します。勝手にずれていく CI 専用の経路はありません。ラップトップに必要なのは fly と git だけ。SQL は fly ssh 経由で Postgres アプリへ行き、環境の Redis キーと Tigris オブジェクトは消す前に環境自身のマシンが削除するので、ラップトップは gitignore された .env.preview 以外に共有 Redis やバケットの認証情報を持ちません。
#!/usr/bin/env bash
# scripts/env up|down|name|url — one environment per branch on shared preview infrastructure
set -euo pipefail
cd "$(git rev-parse --show-toplevel)"
[[ -f .env.preview ]] && { set -a; source .env.preview; set +a; }   # shared-infra credentials; CI secrets in Actions

ORG=${PREVIEW_ORG:-korea-post}
PREVIEW_PG_APP=${PREVIEW_PG_APP:-maru-preview-pg}
BASE_DOMAIN=${BASE_DOMAIN:-marucommunity.com}

branch=${BRANCH:-$(git rev-parse --abbrev-ref HEAD)}
[[ "$branch" == "main" ]] && { echo "main has no branch environment; it has staging" >&2; exit 1; }

slug=$(printf '%s' "$branch" | tr '[:upper:]/_ ' '[:lower:]---' | tr -cd 'a-z0-9-' | cut -c1-20); slug=${slug%-}
hash=$(printf '%s' "$branch" | shasum -a 256 | cut -c1-6)
ENV="${slug}-${hash}"
[[ -n "${ENV_OVERRIDE:-}" ]] && ENV="$ENV_OVERRIDE"       # the sweeper only knows the name
APP="maru-${ENV}"
DB="env_${ENV//-/_}"
HOST="${ENV}-dev.${BASE_DOMAIN}"

pg() { fly ssh console -a "$PREVIEW_PG_APP" -q -C "psql postgres://postgres:${PREVIEW_PG_PASSWORD}@localhost:5433/postgres -At -c \"$1\""; }

up() {
  echo "== $branch -> $ENV"
  # 1. Compute. Idempotent: an app that exists is left alone.
  fly apps list --org "$ORG" --json | grep -q "\"Name\": *\"$APP\"" || fly apps create "$APP" --org "$ORG"

  # 2. Database: clone the seed template unless this branch already has one.
  if [[ "$(pg "SELECT 1 FROM pg_database WHERE datname='$DB'")" != "1" ]]; then
    pg "CREATE DATABASE $DB TEMPLATE seed_template"
  fi
  DATABASE_URL="postgres://postgres:${PREVIEW_PG_PASSWORD}@${PREVIEW_PG_APP}.flycast:5432/${DB}"

  # 3. Secrets. Generated ones are generated once; a later `up` must not rotate them.
  existing=$(fly secrets list -a "$APP" --json 2>/dev/null | grep -o '"Name": *"[^"]*"' | cut -d'"' -f4 || true)
  gen() { grep -qx "$1" <<<"$existing" || printf '%s=%s\n' "$1" "$(openssl rand -hex 32)"; }
  {
    gen SECRET_KEY
    gen ENV_TOKEN
    cat <<S
ENV_NAME=$ENV
ALLOWED_HOSTS=$HOST,$APP.fly.dev
CSRF_TRUSTED_ORIGINS=https://$HOST,https://$APP.fly.dev
DATABASE_URL=$DATABASE_URL
REDIS_URL=$PREVIEW_REDIS_URL
BUCKET_NAME=$PREVIEW_BUCKET
AWS_ENDPOINT_URL_S3=https://fly.storage.tigris.dev
AWS_ACCESS_KEY_ID=$PREVIEW_AWS_ACCESS_KEY_ID
AWS_SECRET_ACCESS_KEY=$PREVIEW_AWS_SECRET_ACCESS_KEY
WS_URL=wss://$HOST
S
  } | fly secrets import -a "$APP" --stage

  # 4. Deploy the working tree, stamped with what it is.
  fly deploy -a "$APP" --config fly.preview.toml --remote-only --ha=false \
    --build-arg GIT_SHA="$(git rev-parse --short HEAD)" --build-arg GIT_BRANCH="$branch" \
    --image-label "$(git rev-parse --short HEAD)"
  echo "https://$HOST"
}

down() {
  [[ "$APP" =~ ^maru-[a-z0-9-]+-[0-9a-f]{6}$ ]] || { echo "refusing to destroy $APP" >&2; exit 1; }
  if fly apps list --org "$ORG" --json | grep -q "\"Name\": *\"$APP\""; then
    fly machine start -a "$APP" >/dev/null 2>&1 || true
    fly ssh console -a "$APP" -q -C "python manage.py env_teardown" || echo "warning: self-teardown failed; the sweeper will catch stragglers" >&2
    fly apps destroy "$APP" --yes
  fi
  pg "SELECT pg_terminate_backend(pid) FROM pg_stat_activity WHERE datname='$DB'" >/dev/null || true
  pg "DROP DATABASE IF EXISTS $DB" || true
}

case "${1:-}" in up) up ;; down) down ;; name) echo "$ENV" ;; url) echo "https://$HOST" ;; esac
デモでは push する代わりに自分のラップトップから走らせました。三つのブランチはリポジトリの履歴に残したくない使い捨てで、出力が流れるのを見ていたかったからです。チームで使うときは誰もこれを打ちません。後で出てくるラベルのワークフローがまさにこのスクリプトを走らせ、ここから先の出力は Actions のログに残るはずのものです。ツール自体を載せたブランチで最初に実行したときの出力です。
$ ./scripts/env up
== feature/branch-environments -> feature-branch-envir-c65cb4
New app created: maru-feature-branch-envir-c65cb4
creating database env_feature_branch_envir_c65cb4 from seed_template
CREATE DATABASE
Secrets have been staged, but not set on VMs. Deploy or update machines in this app for the secrets to take effect.
==> Building image with Depot
image: registry.fly.io/maru-feature-branch-envir-c65cb4:87c061b9
image size: 139 MB
> Machine 865529aee76918 [app] was created
✔ Machine 865529aee76918 [app] update finished: success
https://feature-branch-envir-c65cb4-dev.marucommunity.com

$ curl -s https://feature-branch-envir-c65cb4-dev.marucommunity.com/api/version/
{"environment": "feature-branch-envir-c65cb4", "branch": "feature/branch-environments", "commit": "87c061b9",
 "image": "registry.fly.io/maru-feature-branch-envir-c65cb4:87c061b9", "app": "maru-feature-branch-envir-c65cb4", "region": "syd"}
コマンドから URL まで二分半ほどで、大半はイメージのビルドです。コミットをもうひとつ積んで同じブランチで二度目の up をすると、「New app created」も「creating database」も出ず、同じシークレット名をステージしつつ生成した二つは作り直さず、リビルドしました。同じ URL、新しいコミット。
中の選択のいくつかは一文ずつ値します。
fly.preview.toml は fly.toml ではない。 本番は API、WebSocket サーバー、db_worker を別々の Fly アプリとプロセスグループで動かし、それぞれが自分の指標でスケールするようにしていて、それがスタックの記事の主張のすべてです。ブランチ環境はスケールする必要がありません。マシンひとつであるべきです。だからプレビュー設定はプロセスがひとつで、entrypoint.sh に granian-preview モードが生え、リリースゲートとマイグレーションを走らせてから --ws 付きの ASGI Granian をひとつ起動します。asgi.py の ProtocolTypeRouter は既に http と websocket の両方をルーティングしているので、プロセスひとつでアプリ全体を配信します。そのモードでは同期ビューが thread_sensitive で、だいたい一度にリクエストひとつずつ動きます。本番で自分が捨てたまさにその取引ですが、ここでは正確に正しい取引です。ブランチをテストする人は誰も気づかないからです。
# fly.preview.toml (the app name is supplied by `fly deploy --app`)
app = 'branch-environment-placeholder'
primary_region = 'syd'

[processes]
  app = "granian-preview"

[env]
  DJANGO_SETTINGS_MODULE = 'koreapost_project.settings'
  DEBUG = 'False'
  WEB_BUNDLE_FROM_BUCKET = '0'     # the image's own web bundle; the preview bucket never holds one

[http_service]
  internal_port = 8000
  force_https = true
  auto_stop_machines = 'suspend'
  auto_start_machines = true
  min_machines_running = 0
  [[http_service.checks]]
    path = '/api/health/'
    [http_service.checks.headers]
      Host = '127.0.0.1'           # base.py allows loopback; the app's own hostname isn't known to a static file

[[vm]]
  size = 'shared-cpu-1x'
  memory = '1gb'
auto_stop_machines = "suspend"、min_machines_running = 0。 昼食以降誰も開いていないブランチ環境の費用はゼロであるべきです。stop でなく suspend なら、30 秒のコールドスタートの代わりに 504 を追いかけて たどり着いた 3 秒ほどの再開が得られ、ここでは 30 秒でも許容できます。デモ環境三つのうち二つは、デプロイ完了の一分後には fly apps list で既に suspended でした。
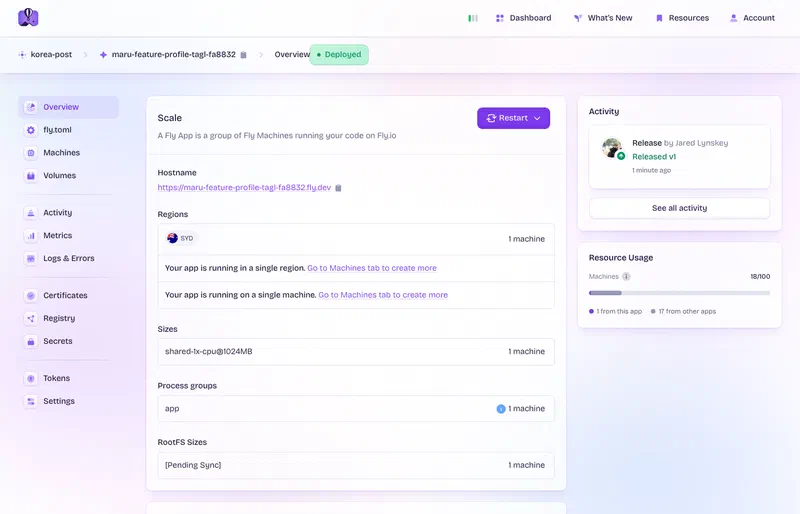
DEBUG = False、本番と同じ settings モジュール。 ブランチ環境は公開 URL です。テストに関わるすべての面(本物の HTTPS、本物のクッキー、同じヘルスチェック)で本番のように振る舞い、誰かを傷つけうるすべての面で本番と違うべきです。別の preview.py を用意する代わりに、差分は env up が設定するシークレットが運びます。サンドボックスの決済キー、Firebase 管理者認証情報なし、そして以下のすべての接頭辞を有効にする ENV_NAME。
設定ひとつがすべてを切り分ける。 ENV_NAME は settings/base.py に新しく入った唯一のつまみで、四か所に適用されます。
ENV_NAME = os.getenv("ENV_NAME", "")
_ENV_PREFIX = f"{ENV_NAME}/" if ENV_NAME else ""

CACHES["default"]["KEY_PREFIX"] = ENV_NAME                     # every cache key, and the list-cache version counters
CHANNEL_LAYERS["default"]["CONFIG"]["prefix"] = f"{ENV_NAME}:asgi"  # group and channel names
STORAGES["default"]["OPTIONS"]["location"] = f"{_ENV_PREFIX}media"  # uploads
STORAGES["staticfiles"]["OPTIONS"]["location"] = f"{_ENV_PREFIX}static"
channels の分を忘れると、二つのブランチの WebSocket サーバーがグループ名を共有し、ある環境で送ったメッセージが別の環境に現れます。一日を食う種類のバグです。
五か所目は、後から共有 Redis を読んで初めて見つけました。504 の記事のリリースゲート、つまりイメージごとにマシン一台がマイグレーションを走らせる間ほかが待つ仕組みは、イメージ参照のハッシュでロックのキーを作ります。同じコミットから組まれたブランチ環境二つは同じイメージを持ちます。二つ目は一つ目の「done」マーカーを見つけて、マイグレーションされていない自分のデータベースへの自分のマイグレーションを飛ばしていたでしょう。今は環境名がハッシュされる値に含まれ、キーは接頭辞の下に住んでいます。共有インフラの設計が生み続ける種類の問題です。暗黙のうちに「デプロイごと」だったものはすべて明示的に環境ごとにしなければならず、何が暗黙だったかは見るまで分かりません。
データベースは空からマイグレーションするのではなく複製する。 次の節です。
データベース: 数秒で複製されるテンプレート#
ブランチ環境のデータベースは三つのうちのどれかです。全員と共有。ここまで我々を連れてきたやり方です。空からマイグレーションしてフィクスチャでシード。決定論的ですが、フィクスチャが実物の形をしたデータに敵ったことはなく、いつも十八か月は古い。あるいは本番の形のスナップショットの複製。現実的な行数、フィクスチャが常に埋まっていると仮定していたカラムの現実的な null、空のテーブルでは一瞬で終わるが実物では四十分かかるマイグレーションが姿を現します。
三つ目を採り、二つ目は CI 専用のチェックとして残します。そして三つ目をブランチごとにやれるほど速くするのは、多くの人が存在を忘れている Postgres の機能です。
-- Nightly, on maru-preview-pg. Restore last night's prod backup into seed_raw,
-- run the anonymiser, then freeze it as a template nobody can connect to.
ALTER DATABASE seed_raw RENAME TO seed_template;
UPDATE pg_database SET datistemplate = true, datallowconn = false WHERE datname = 'seed_template';

-- Per branch, in the time it takes to copy the files:
CREATE DATABASE env_feature_payments_retr_3f9a1c TEMPLATE seed_template;
CREATE DATABASE ... TEMPLATE はクラスタ内のファイルレベルのコピーです。数ギガバイトなら pg_restore にかかる数分ではなく数秒です。複製中のテンプレートには開いた接続があってはならず、datallowconn = false がそれを強制します。夜間ジョブが生きているテンプレートの上にリストアするのではなく seed_raw に組んで最後にリネームするのもそのためです。
デモではテンプレートを本番ダンプからではなく手で作りました。fly proxy でプレビュークラスタにトンネルを掘り、manage.py migrate、それからリポジトリ自前のシードコマンドで分類体系、会話付きの買い手と売り手、コミュニティ投稿二十件。十九メガバイト。ブランチが三つ上がるにつれてクラスタにその複製が三つ現れ、それぞれ 19 MB、それぞれ一秒未満でした。
$ fly ssh console -a maru-preview-pg -C "psql ... -c '\l'"
             datname             | template | size
---------------------------------+----------+-------
 env_feature_branch_envir_c65cb4 | f        | 19 MB
 env_feature_profile_tagl_fa8832 | f        | 19 MB
 env_feature_profile_webs_dcb2e7 | f        | 19 MB
 seed_template                   | t        | 19 MB
プレビュークラスタは非マネージドの Fly Postgres ノードひとつ、1 GB ボリューム付きの shared-cpu-1x で、月に二ドルほどです。ブランチ環境はプライベートネットワークの .flycast 経由でつなぎます。公開されているものは何もありません。
匿名化は省略できません。本番データが -dev ホスト名で届く瞬間、それは本番データであってはなりません。名前、メール、電話番号、住所、自由記述、決済参照、トークン、すべてリネームの前に上書きします。匿名化が失敗したら前夜のテンプレートが残り、誰かにメッセージが飛びます。小さな仕事で、このアプローチ全体をプライバシー質問票に答える人が受け入れられるものにする、まさにその仕事です。
entrypoint.sh のリリースゲートがすべてのイメージの初回起動で migrate を走らせるので、ブランチ自身のマイグレーションがテンプレートの上に適用されます。「自分のマイグレーションは本番の形のデータで動くか」の最初の正直なテストで、誰かが URL を開く前に起きます。
ホスト名: ワイルドカードひとつ、Worker ひとつ、そしてドキュメントが教えてくれなかった二つのこと#
すべての環境には公開の HTTPS ホスト名が必要で、「公開」が要点です。スマホを持ったテスター、別のネットワークのデザイナー、VPN を入れないプロダクトマネージャー。Fly はアプリごとに maru-$ENV.fly.dev を無料でくれて、それだけでも動きます。ただ *.fly.dev ホスト名には問題が三つあります。送るには不格好で、前に Cloudflare がいないので本番にかけている保護がひとつも効かず、自分のドメインに置きたければ環境ごとに DNS レコードひとつと証明書ひとつを作ることになり、スイーパーの片付けものがひとつ増えます。
それを全部なくす版が、ワイルドカードひとつと Cloudflare Worker ひとつです。計画は *.dev.marucommunity.com でした。二つのことに止められ、どちらも同じ計画を立てる前に知っておく価値があります。
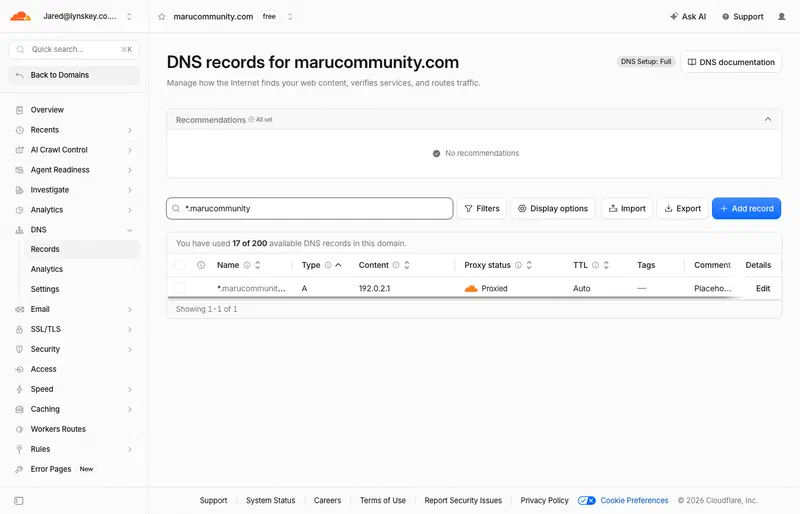
Universal SSL が覆うワイルドカードは一段だけ。 Cloudflare の無料証明書は marucommunity.com と *.marucommunity.com に発行されます。*.dev.marucommunity.com は覆いません。二段目のワイルドカードには月 10 ドルの Advanced Certificate Manager が要ります。feature-branch-envir-c65cb4.dev.marucommunity.com への最初のリクエストは、自分のものが何ひとつ動く前に SSL ハンドシェイク失敗で死にました。対処は環境を最初のラベルに置くことです。feature-branch-envir-c65cb4-dev.marucommunity.com。既にある証明書が覆い、既にあるプロキシ済みの *.marucommunity.com レコードが覆います。でっち上げのサブドメインを歩き回るスキャナー向けのシンクホールとして自分が置いたあのレコードです。だから環境に DNS は一切要りません。
Redirect Rules は Workers より先に走る。 ルートを置いたところ、すべての -dev ホスト名が Worker が動くことなく www のトップページへ 301 で答えました。シンクホールはゾーンレベルのリダイレクトルール「その他のサブドメインはすべて → www」で、Cloudflare のリダイレクトフェーズは Workers フェーズより前に実行されます。ルールに節がひとつ必要でした。and not ends_with(http.host, "-dev.marucommunity.com")。デプロイスクリプトが up で足し down で外します。誰かが手で編集したルールこそ忘れられるものだからです。
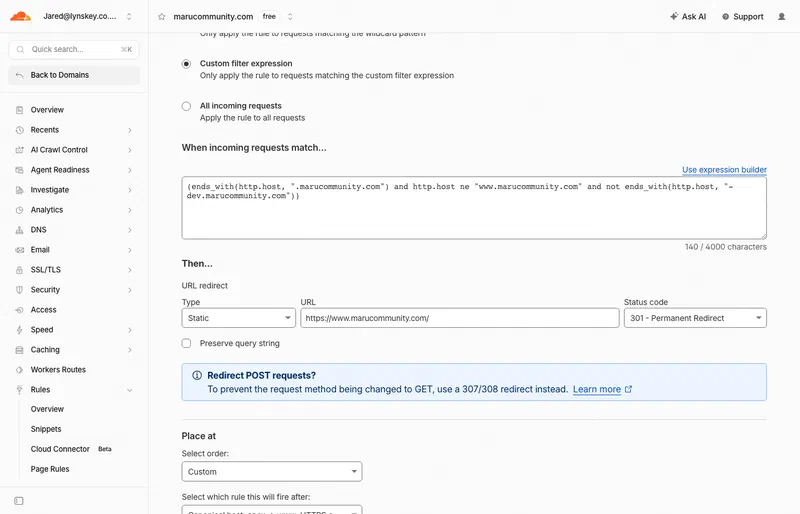
-dev.marucommunity.com で終わるホスト名だけが Worker へ流れます。DNS 側は元からあったあのレコードです。
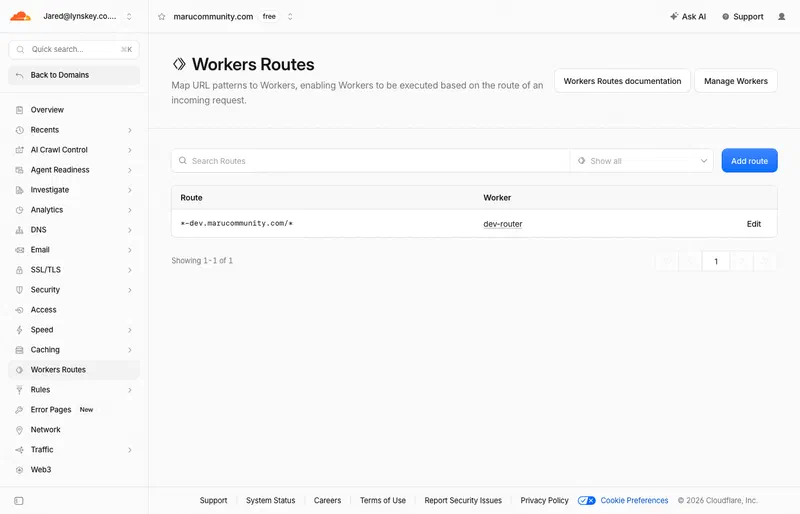
その二つを片付ければ、ルーティングは *-dev.marucommunity.com/* の Worker ひとつです。
// infra/dev-router.js — <env>-dev.marucommunity.com -> maru-<env>.fly.dev
const DEV_SUFFIX = "-dev.marucommunity.com";
const ENV_NAME = /^[a-z0-9-]+-[0-9a-f]{6}$/;   // slug-hash, as scripts/env names them

export default {
  async fetch(request) {
    const url = new URL(request.url);
    if (!url.hostname.endsWith(DEV_SUFFIX)) return new Response("not a dev hostname", { status: 404 });
    const env = url.hostname.slice(0, -DEV_SUFFIX.length);
    if (!ENV_NAME.test(env)) return new Response(`no such environment: ${env}`, { status: 404 });

    url.hostname = `maru-${env}.fly.dev`;
    const upstream = new Request(url, request);
    upstream.headers.set("X-Forwarded-Host", request.headers.get("host") ?? "");

    const res = await fetch(upstream);
    const out = new Response(res.body, res);
    out.headers.set("X-Robots-Tag", "noindex, nofollow");   // a half-finished branch is not for search engines
    out.headers.set("X-Dev-Environment", env);
    return out;
  },
};
Cloudflare がワイルドカードで TLS を終端し、Worker がラベルから Fly ホスト名を計算し、マシンまでの区間は Fly 自身の *.fly.dev 証明書が覆います。WebSocket のアップグレードは fetch をそのまま通ります。そしてルートがゾーンにあるので、Cloudflare が本番にしてくれることはすべて使えます。WAF ルール、レート制限、ボット対策モード、そして Access。
ブランチ三つを同時に上げ、Worker ひとつ、各ホスト名が答えたもの。
| ホスト名 | HTTP | ルーティング先 | branch | commit |
|---|---|---|---|---|
feature-branch-envir-c65cb4-dev.marucommunity.com | 200 | maru-feature-branch-envir-c65cb4.fly.dev | feature/branch-environments | 6560ec9a |
feature-profile-tagl-fa8832-dev.marucommunity.com | 200 | maru-feature-profile-tagl-fa8832.fly.dev | feature/profile-tagline | e3baa936 |
feature-profile-webs-dcb2e7-dev.marucommunity.com | 200 | maru-feature-profile-webs-dcb2e7.fly.dev | feature/profile-website | beb08161 |
not-an-env-dev.marucommunity.com | 404 | なし。Worker がラベルを拒否 |
すべての 200 には Worker が付けた X-Robots-Tag: noindex, nofollow と X-Dev-Environment: <env> が添えられていました。404 は Fly に尋ねる前に Worker 自身が返したものです。
Cloudflare Access は「公開」を「届くべき人に届く」に変える装置です。*-dev.marucommunity.com にアプリケーションひとつ、「@marucommunity.com のメールなら誰でも」というポリシーひとつで、ブラウザからの訪問者はログインページを一度見て二度と気にしなくなります。ラップトップのデザイナー、PM、テスターはそれで済みます。デモには入れませんでした。環境は一時間、noindex を付けてシードデータ以外何もない状態で上がっていました。
モバイルアプリは覆えません。ネイティブアプリは Access のログインリダイレクトを完了できないからです。道は二つ。Access はログインを迂回するサービストークン(CF-Access-Client-Id / CF-Access-Client-Secret のヘッダー対)をサポートしていて、Expo アプリの dev メニューが dev ホスト名用の一対を持てます。あるいはもっと単純に、/api/ に Access の迂回を入れ、Firebase ユーザーか環境の ENV_TOKEN、つまり env up がまさにこの環境のために生成したあのトークンのどちらもないリクエストを Django が拒否するようにします。どちらでも、Expo 側はベース URL とトークンの二つのフィールドを持つ dev メニュー画面で、テスターが既にインストールしているアプリがそのブランチと話すようになります。新しいビルドは要りません。OTA 更新チャネルはアプリがビルドされたときのものを指したままで、API のベース URL はビルド時ではなく実行時の設定であり、元々そうあるべきでした。
Firebase Auth は意図的に共有する唯一の共有サービスです。identity は環境ごとのものではありません。テスターはどのブランチでも同じアカウントでログインしたい。承認済みドメインに marucommunity.com を入れた dev 用 Firebase プロジェクトひとつがすべての -dev ホスト名を覆い、すべての環境がそれに対して ID トークンを検証します。各環境のデータベースのユーザーテーブルはテンプレートのユーザーのコピーなので、テスターのアカウントはテンプレートにあったすべての場所にあります。
GitHub で自動化する: イベントが入り、環境が出る#
上のすべてを手でやるのは、やるのが自分だけなら構いません。二人目の開発者がいる時点で、誰かが覚えていたからではなく git で何かが起きたから起きなければなりません。自動化の全体はワークフロー四つ、リポジトリ設定ひとつ、ルールセットひとつ、GitHub environment ひとつで、そのどれもが git イベントを、開発者が手で走らせるのと同じ scripts/env の呼び出しに対応させます。勝手にずれる CI 専用の経路はありません。
| Git イベント | 走るもの | すること |
|---|---|---|
PR に env ラベルが付く | branch-env.yml → scripts/env up | そのブランチの環境を作り、PR に URL を投稿 |
| ラベル付き PR のブランチへの push | branch-env.yml → scripts/env up | その場で更新 |
| ラベル削除、PR のクローズまたはマージ | branch-env.yml → scripts/env down | 環境が自分の一切れを片付けて消える |
| ブランチ削除 | branch-env.yml → scripts/env down | 手で立ち上げて PR のなかったブランチのための保険; リポジトリ設定 delete branch on merge がマージ時にもこれを発火させる |
| それ以外のブランチへの push | 何もしない | バックアップの push やスパイクは、誰かが見たいと言うまで費用ゼロ |
main への pull request | migrations-check.yml | main をマージした後のマイグレーショングラフの葉がひとつか; 空からチェーン全体が適用できるか |
v* タグの push | release.yml | タグからステージング環境; レビュアーの承認が同じイメージを本番に昇格しステージングを消す |
| 毎晩 02:00 | sweep-envs.yml → scripts/sweep-envs | ブランチが消えたか一週間放置のものをすべて消す |
ラベル、push、delete のワークフロー#
# .github/workflows/branch-env.yml
name: branch environment
on:
  pull_request:
    types: [labeled, unlabeled, synchronize, closed]
  delete:
  workflow_dispatch:
    inputs:
      branch:
        description: branch to bring up without a PR
        required: true

concurrency:
  group: env-${{ github.head_ref || github.event.ref || inputs.branch }}
  cancel-in-progress: true

env:
  FLY_API_TOKEN: ${{ secrets.FLY_PREVIEW_TOKEN }}        # org-scoped deploy token; a separate preview org keeps it away from prod
  PREVIEW_PG_PASSWORD: ${{ secrets.PREVIEW_PG_PASSWORD }}
  PREVIEW_REDIS_URL: ${{ secrets.PREVIEW_REDIS_URL }}
  PREVIEW_BUCKET: ${{ vars.PREVIEW_BUCKET }}
  PREVIEW_AWS_ACCESS_KEY_ID: ${{ secrets.PREVIEW_AWS_ACCESS_KEY_ID }}
  PREVIEW_AWS_SECRET_ACCESS_KEY: ${{ secrets.PREVIEW_AWS_SECRET_ACCESS_KEY }}

jobs:
  up:
    # the gate: a PR carrying the `env` label, or someone asking for a branch by hand
    if: >-
      github.event_name == 'workflow_dispatch' ||
      (github.event_name == 'pull_request' && github.event.action != 'closed'
        && contains(github.event.pull_request.labels.*.name, 'env'))
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
        with:
          ref: ${{ github.head_ref || inputs.branch }}
      - uses: superfly/flyctl-actions/setup-flyctl@master
      - id: env
        env:
          BRANCH: ${{ github.head_ref || inputs.branch }}
        run: |
          scripts/env up
          echo "url=$(scripts/env url)" >> "$GITHUB_OUTPUT"
      - if: github.event_name == 'pull_request'
        uses: marocchino/sticky-pull-request-comment@v2
        with:
          header: env
          message: |
            Branch environment: ${{ steps.env.outputs.url }}
            Commit: `${{ github.event.pull_request.head.sha }}` · `/api/version/` says what it is running.

  down:
    # label removed, labelled PR closed or merged, or the branch itself deleted
    if: >-
      (github.event_name == 'pull_request' &&
        ((github.event.action == 'closed' && contains(github.event.pull_request.labels.*.name, 'env')) ||
         (github.event.action == 'unlabeled' && github.event.label.name == 'env'))) ||
      (github.event_name == 'delete' && github.event.ref_type == 'branch')
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: superfly/flyctl-actions/setup-flyctl@master
      - run: BRANCH="${{ github.head_ref || github.event.ref }}" scripts/env down
ゲートは env ラベルで、ここは自分がいちばん強く主張したい部分です。ゲートがないと、すべてのブランチがアプリひとつとデータベースの複製ひとつの費用を払います。ラップトップのバックアップ代わりに push したブランチ、明日 squash されるスパイク、ボットが午前三時に開いた依存関係の更新まで。だから push だけでは何も起きず、PR を開くだけでも何も起きません。PR に env を付けると環境が立ち上がり、ラベルが付いている間は push のたびに更新され、ラベルを外すか PR を閉じるかマージすると落ちます。オプトインは依然として GitHub のイベントであって人への依頼ではなく、誰かが見るかどうかを知っている唯一の人がするクリックひとつです。固定コメントがユーザーインターフェースです。PR にラベルを付けると、誰にでも送れる URL 付きのコメントが現れ、push のたびに積み上がるのではなくその場で更新されます。PR ができる前に立ち上げたいブランチは workflow_dispatch が、残りはラップトップからの ./scripts/env up が受け持ちます。
知っておく価値のあるゲートが他に二つあります。ブランチ名のフィルタ (branches: ['feature/**', 'fix/**']) は PR が要りませんが、すべての機能ブランチが費用を払います。「ドラフトでないすべての PR」はいちばん自動的で、チームが PR を遅く、準備できたときにだけ開くなら正しい選択です。自分がラベルを選んだのは、費用の判断を文脈を知っている人に置けることと、何も閉じずに取り消せることからです。気に入っている副作用がひとつ。フォークからの pull_request の実行にはシークレットが渡らないので、フォークは環境を立ち上げられません。
concurrency は見た目以上に重要です。ひとつのブランチへの立て続けの push は、先行のデプロイと競走させるのではなく取り消します。同じアプリへの fly deploy が二つ同時に走ると、片方が負ける結果になります。
PR があったものは、マージされたかどうかにかかわらず closed が片付けを受け持ちます。delete イベントは workflow_dispatch で立ち上げて結局 PR ができなかったブランチのための保険で、ブランチが実際に削除されたときにしか発火しません。それはリポジトリ設定 Automatically delete head branches で、既定ではオフです。オンにしておけば、Merge を押すことが PR を閉じてブランチを削除するので、どちらのイベント単独でも env down が走っていたはずです。マージボタンが片付けです。
gh api -X PATCH repos/jaredlynskey/koreapost -f delete_branch_on_merge=trueFLY_PREVIEW_TOKEN がこのファイルで危険な行です。アプリを作り消せるので、$APP がブランチ環境以外の何かになった瞬間に本番を消せてしまいます。ガードは二つで、両方残します。トークンを別の Fly 組織に限定し、本番組織を文字どおり見えなくすること(デモでは新しい組織に課金情報を付ける手間を省くため本番組織 korea-post を使い、二つ目のガードだけに頼りました)。そして down() が slug-hash パターンに合わないアプリ名をすべて拒否すること。
ブランチ環境が自分ではできないチェック#
ブランチは自分のマイグレーションしか見ません。だから肝心のチェックは pull request で main をマージした状態に対して走り、main が要求する唯一のステータスチェックです。
# .github/workflows/migrations-check.yml
name: migrations
on:
  pull_request:
    branches: [main]

jobs:
  check:
    runs-on: ubuntu-latest
    services:
      postgres:
        image: postgres:18
        env: { POSTGRES_PASSWORD: ci, POSTGRES_DB: ci }
        ports: ['5432:5432']
        options: --health-cmd pg_isready --health-interval 5s --health-timeout 5s --health-retries 10
    env:
      DATABASE_URL: postgres://postgres:ci@localhost:5432/ci
      DEBUG: 'False'
      SECRET_KEY: ci-only
    steps:
      - uses: actions/checkout@v4
        with: { fetch-depth: 0 }
      - uses: astral-sh/setup-uv@v4
      - run: uv sync --frozen
      - name: Merge main into the branch (a conflict here fails the check too)
        run: |
          git config user.email [email protected] && git config user.name ci
          git merge --no-edit origin/main
      - name: One leaf in the migration graph
        run: |
          uv run manage.py makemigrations --check --dry-run
          uv run manage.py migrate --plan > /dev/null
      - name: The full chain applies from nothing
run: uv run manage.py migrate --noinput三十秒。0114 / 0114 の衝突をリリース当日の驚きから二人目の開発者の PR の赤いチェックに変えるのがこれです。下のマイグレーションの節で実際に発火するところを示します。
main の規則#
ブランチが一か月生きたり、誰かが main に直接 push したりすれば、このどれも持ちません。規則は保護というより、環境を小さく、マイグレーションを最新に保つためのものです。
mainは保護され、常にデプロイ可能。 現在のmainに対してmigrationsチェックが緑の PR でだけマージします(strict なステータスチェックなので、先週緑だった PR はmainが動けば再実行されます)。線形履歴、force-push 禁止、削除禁止。- 機能ブランチは短い。 二週間開いているブランチは
mainより二週間遅れた環境と、他人のものと衝突する確率が二週間分高いマイグレーションを持ちます。一か月がかりの機能はフラグの裏で小分けにmainへマージします。長生きするのはフラグであってブランチではありません。 - ブランチひとつ、環境ひとつ、データベースひとつ。 既に命名が強制しています。
- 本番に行くのはリリースタグだけ。 イメージはタグから一度組まれ、ステージングと本番はそのイメージを動かします。リビルドはしません。
migrations/に触れる PR は残りの二人のどちらかがレビューする。 後述。
ルールセットとしては、gh api -X POST repos/…/rulesets --input infra/github-ruleset-main.json で一度だけ適用します。
{
  "name": "main", "target": "branch", "enforcement": "active",
  "conditions": { "ref_name": { "include": ["~DEFAULT_BRANCH"], "exclude": [] } },
  "rules": [
    { "type": "deletion" },
    { "type": "non_fast_forward" },
    { "type": "required_linear_history" },
    { "type": "pull_request",
      "parameters": { "required_approving_review_count": 1, "dismiss_stale_reviews_on_push": true,
                      "required_review_thread_resolution": true } },
    { "type": "required_status_checks",
      "parameters": { "strict_required_status_checks_policy": true,
                      "required_status_checks": [ { "context": "check" } ] } }
  ]
}
正直なひっかかりがひとつ。このリポジトリは GitHub Free プランのプライベートリポジトリで、Free ではブランチ保護とルールセットはパブリックリポジトリでしか使えません。API は 403 Upgrade to GitHub Pro or make this repository public と答えます。delete_branch_on_merge 設定、environment、ワークフローは Free でもすべて動きます。だからプライベートな Free リポジトリの小さなチームにとって、上のルールセットは慣習です。migrations ワークフローは変わらず走り、変わらず赤くなりますが、マージボタンを灰色にするものはありません。月 4 ドルの判断で、自分なら二人目がマージできるようになった瞬間にそうします。
develop ブランチも release/* ブランチもありません。Git-flow は統合が高くつき、まとめてやらざるを得ないという前提で設計されました。ブランチ環境が統合を安くするので、まとめる必要が消えます。
ステージングはタグの環境で、本番は昇格#
ステージングは仕組み全体を再利用します。main の v* タグがブランチ名 staging/v1.42.0 で scripts/env up を走らせ、命名がそれを staging-v1-42-0-<hash> に変えます。同じテンプレート複製のデータベース、同じ放置で suspend されるマシン、同じホスト名の体系。違うのはその後です。
# .github/workflows/release.yml (abridged)
on:
  push:
    tags: ['v*']
jobs:
  staging:
    steps:
      - run: BRANCH="staging/${GITHUB_REF_NAME}" scripts/env up
      - run: echo "image=$(fly image show -a "maru-$(BRANCH=staging/$GITHUB_REF_NAME scripts/env name)" --json | jq -r '…')" >> "$GITHUB_OUTPUT"
  production:
    needs: staging
    environment: production        # required reviewer on this environment = the promotion gate
    steps:
      - run: fly deploy --config fly.api.toml --image "${{ needs.staging.outputs.image }}"
      - run: fly deploy --config fly.ws.toml  --image "${{ needs.staging.outputs.image }}"
      - run: BRANCH="staging/${GITHUB_REF_NAME}" scripts/env down
production ジョブは必須レビュアーのいる GitHub environment を待ちます。誰かがステージングを見て Approve を押すと、本番はステージングが動かした同じイメージを参照で受け取ります。リビルドではありません。最後のステップがステージングを消すのは、役目を終えたからです。誰も承認しなければリリース候補は却下されたということで、その「ブランチ」(staging/v1.42.0 は origin に存在したことがない)が生存チェックに落ちたときにスイーパーがステージングを片付けます。スイーパーが確認できる理由なしには何も存在できません。
毎晩のスイーパー#
# .github/workflows/sweep-envs.yml
on:
  schedule:
    - cron: '0 14 * * *'     # 02:00 NZST
  workflow_dispatch:
jobs:
  sweep:
    steps:
      - uses: actions/checkout@v4
        with: { fetch-depth: 0 }
      - uses: superfly/flyctl-actions/setup-flyctl@master
      - run: scripts/sweep-envs
fetch-depth: 0 なのは、スイーパーが Actions が既定でチェックアウトする一コミットではなく、すべてのリモートブランチとその最終コミット日時を必要とするからです。workflow_dispatch はインシデントの後に手で走らせられるようにするためです。
開発者が実際にすること#
ブランチを push し、PR を開き、誰かに見てほしくなったら env ラベルを付ける。リストはそれだけです。三分以内に PR に URL が現れ、push のたびに更新され、PR がマージされるか閉じられれば消えます。チームメイトと衝突していれば、マイグレーションチェックが誰より先に教えてくれます。取り合うステージングがないので誰もステージングを取り合わず、片付けがマージそのものなので誰も何も片付けません。
そして、これを組んだ人がその後ブランチごとにやることは、何もありません。共有の Postgres、Redis、バケットは一度だけ用意し、シークレットは Actions に一度だけ入れ、そこから先に繰り返す作業といえば月曜にスイーパーのログを読むことくらいです。チケットの列も、呼ぶボットも、プロンプトを打つ相手もありません。
片付けを信用しない片付け#
env down が通常の場合で、面白いのは誰が掃除するかです。Redis のキーと Tigris のオブジェクトは共有サービスのもので、down を走らせるラップトップはどちらの認証情報も要りません。環境自身のマシンが既にそれを持ち、自分の接頭辞を既に知っているからです。だから down はマシンが suspend されていれば起こし、そこで manage.py env_teardown を走らせ、その後で初めてアプリを消しデータベースをドロップします。環境が自分で後片付けをします。
$ BRANCH=feature/profile-website ./scripts/env down
== feature/profile-website -> feature-profile-webs-dcb2e7 (destroying)
redis: deleted 0 keys under feature-profile-webs-dcb2e7:*
tigris: deleted 278 objects under maru-preview/feature-profile-webs-dcb2e7/
Destroyed app maru-feature-profile-webs-dcb2e7
DROP DATABASE
destroyed feature-profile-webs-dcb2e7

$ curl -s -o /dev/null -w '%{http_code}\n' https://feature-profile-webs-dcb2e7-dev.marucommunity.com/api/version/
530
530 は調整についての要点をもう一度示しています。Worker は変わらずホスト名をルーティングし、Fly には何もなく、誰も Cloudflare に知らせる必要がありませんでした。
env_teardown は ENV_NAME なしでは実行を拒否します。接頭辞が空なら共有バケットの全消去になってしまうからです。そのガードこそ、このコマンドがシェルスクリプトの三行ではなくコマンドとして存在する理由のすべてです。
それでも環境は漏れます。GitHub Actions の障害中にブランチが削除される。開発者が試作のためにラップトップから env up を走らせ、push はしないまま。fly apps destroy が一時的に失敗して || true が飲み込む。三か月後にアプリが四十個あり、誰かに何が起きたのかと問わせる請求書が来ます。
だから一つ目を信用しない二つ目の仕組みがあります。上の表の毎晩のスイーパーです。すべての maru-* アプリを列挙し、それぞれがどのブランチのものか割り出し、ブランチが消えたか七日間 push のないものをすべて消します。一週間放置されたブランチに生きた URL は要らず、次の push が二分で作り直します。ハッシュは逆算できないので、スイーパーは生きているすべてのブランチの環境名を計算し、その集合にないアプリをすべて消してから、背後にアプリのない env_* データベースをドロップします。
#!/usr/bin/env bash
# scripts/sweep-envs — nightly
set -euo pipefail
cd "$(git rev-parse --show-toplevel)"
[[ -f .env.preview ]] && { set -a; source .env.preview; set +a; }
ORG=${PREVIEW_ORG:-korea-post}; TTL_DAYS=${TTL_DAYS:-7}
cutoff=$(( $(date +%s) - TTL_DAYS*86400 ))

git fetch --prune --quiet origin
live=""
while IFS=$'\t' read -r ts branch; do
  [[ "$branch" == "main" ]] && continue
  (( ts >= cutoff )) || continue
  live+="$(BRANCH="$branch" scripts/env name)"$'\n'
done < <(git for-each-ref --format='%(committerdate:unix)%09%(refname:short)' refs/remotes/origin | sed 's#^\([0-9]*\)\torigin/#\1\t#')

apps=$(fly apps list --org "$ORG" --json | grep -o '"Name": *"maru-[^"]*"' | cut -d'"' -f4)
for app in $apps; do
  env="${app#maru-}"
  [[ "$env" =~ ^[a-z0-9-]+-[0-9a-f]{6}$ ]] || continue       # not a branch environment (e.g. maru-preview-pg)
  grep -qx "$env" <<<"$live" && continue
  echo "sweeping $app: branch gone or idle > ${TTL_DAYS}d"
  ENV_OVERRIDE="$env" scripts/env down || true
done
# ...then any env_* database with no app: DROP DATABASE.
デモのブランチはどれも push されたことがなかったので (上のラップトップでの実行です)、スイーパーから見ればすべて消えたものでした。誰かがラップトップから立ち上げて結局 push しなかったスパイクが一週間後に置かれる状態が、まさにこれです。残りの二つを、tagline 環境が書き込んだ Redis キーも含めて解体しました。
$ ./scripts/sweep-envs
sweeping maru-feature-branch-envir-c65cb4: branch gone or idle > 7d
redis: deleted 0 keys under feature-branch-envir-c65cb4:*
tigris: deleted 322 objects under maru-preview/feature-branch-envir-c65cb4/
Destroyed app maru-feature-branch-envir-c65cb4
DROP DATABASE
sweeping maru-feature-profile-tagl-fa8832: branch gone or idle > 7d
redis: deleted 3 keys under feature-profile-tagl-fa8832:*
tigris: deleted 278 objects under maru-preview/feature-profile-tagl-fa8832/
Destroyed app maru-feature-profile-tagl-fa8832
DROP DATABASE

$ fly apps list --org korea-post | grep maru-
 maru-preview-pg │ korea-post │ deployed
(小さく噛まれたことがひとつ。macOS には連想配列のない bash 3 が付いてきます。スイーパーの最初の版はそれを使っていて、自分のラップトップで declare -A で死にました。上の版は改行区切りのリストを使い、どこでも動きます。)
費用は楽しい部分です。suspend されたマシンは rootfs 分だけで、月に数セント。データベースは既に払っているボリューム上の 19 MB。Redis は Upstash の従量課金プランで、十万コマンドあたり 20 セント、ブランチテストの規模ではゼロに丸まります。Tigris の接頭辞は保存した分だけ。共有 Postgres ノードが唯一の固定費で、月に二ドルほど。アクティブなブランチ二十本で常時稼働の shared-cpu-1x 一台分くらいで、スイーパーがそれを二百ではなく二十に保ちます。デモ全体、つまり一時間の環境三つと共有部品は、その間に飲んだコーヒーより安くつきました。
ブランチをまたぐマイグレーション、警告してくれる共有データベースなしで#
各開発者が機能を端から端まで持つなら、すべてのブランチにマイグレーションが入っています。だからこの節が重要な節です。
共有環境の世界を離れるときに人が見落とすことがあります。全員がひとつの dev データベースにデプロイしていたとき、マイグレーションの衝突は即座に痛く表面化しましたが、ともかく表面化しました。マイグレーションがひとつ走り、次のデプロイが失敗し、誰かがその日の午後に直した。ブランチごとにデータベースがあると、各マイグレーションは自分の環境で完璧に動き、二つは二つ目が main にマージされたときに初めて出会います。不注意にやれば、衝突は安かった dev から安くないリリースへ移ります。
規則は四つ、すべて CI で強制できるので誰も覚えておく必要がありません。
1. main をマージした状態でマイグレーショングラフの葉が二つなら CI が失敗する。 makemigrations --check はモデルとマイグレーションの食い違いを捕まえますが、肝心の衝突は二つのブランチが両方とも 0042_* を足していることです。ブランチ単体ではなく、main にマージしたブランチに対して確認します。
git fetch origin main
git merge --no-commit --no-ff origin/main || { echo "merge conflict"; exit 1; }
python manage.py makemigrations --check --dry-run
python manage.py migrate --plan 2>&1 | grep -q "Conflicting migrations" && exit 1これは自分でわざと起こしたものです。デモブランチ三つのうち二つ、feature/profile-tagline と feature/profile-website が、それぞれマイグレーションひとつで UserProfile にフィールドをひとつ足し、各環境は上がる途中で自分のものを適用しました。カラムはあるべき場所にだけありました。
env_feature_branch_envir_c65cb4      pending_email
env_feature_profile_tagl_fa8832      pending_email, tagline
env_feature_profile_webs_dcb2e7      pending_email, website
両方とも 0114_* です。どちらのブランチも相手のものを見られないので、どちらの環境も問題があるとは教えてくれません。片方をもう片方にマージすると、チェックが教えてくれます。
$ git merge --no-commit --no-ff feature/profile-tagline
$ python manage.py makemigrations --check --dry-run
CommandError: Conflicting migrations detected; multiple leaf nodes in the migration graph:
  (0114_userprofile_tagline, 0114_userprofile_website in marketplace).
To fix them run 'python manage.py makemigrations --merge'

$ python manage.py makemigrations --merge --noinput
Created new merge migration marketplace/migrations/0115_merge_20260919_0324.py
    dependencies = [
        ('marketplace', '0114_userprofile_tagline'),
        ('marketplace', '0114_userprofile_website'),
    ]
二人目の作者が自分のブランチで、自分の環境で、誰の邪魔もせずにその --merge を走らせ、次の env up が自分の複製の上に 0115 を適用します。(この場合、git が先にテキストの競合も報告しました。両方のフィールドがモデルファイルの同じ行に足されていたからです。現実的で、テキストの競合が解消されるまでマイグレーションの衝突を隠すことは知っておく価値があります。)
2. マイグレーションは前のリリースのコードと後方互換である。 デプロイ中には新しいスキーマと古いコードが共存する窓があり、マシンがロールバックすればその逆もあります。カラムは nullable かデフォルト付きで足し、一度にリネームせず、現在のリリースがまだ読むものは決してドロップしない。足して、デプロイして、バックフィルして、コードを切り替えて、後のリリースでドロップする。expand and contract です。ここでより重要になる理由は、使い捨て環境がデプロイを頻繁にし、その窓の中にいる時間が増えるからです。タグごとのステージングがそれをリハーサルする場所です。
3. CI は空のデータベースにゼロからのマイグレーションもする。 テンプレートの複製は「自分のマイグレーションが現実的なデータに適用できるか」をテストします。空からの実行は「チェーン全体がまだ無から動くか」をテストし、前のデータマイグレーションが何かを埋めたと仮定していたマイグレーションを捕まえます。三十秒で、さもなければ次の新しいラップトップを待つ類のバグを捕まえます。
4. スキーマ変更には二つ目の目が付く。 小さなチームに CODEOWNERS ファイルは要りませんが、規則は要ります。migrations/ に触れる PR はマージ前にチームの誰かがレビューし、レビュアーの仕事は SQL を確認することではありません。自分かチームの他の誰かがこの二週間で同じテーブルに触れているかを知っていて、そう言うことです。開発者が十数人を超えるとその知識はひとりの頭に収まらなくなるので、そこで migrations/ への CODEOWNERS の記述が元を取ります。どんなツールもこれの代わりにはなりません。機械的なものはツールが全部捕まえてくれるので二分の仕事で、古い共有環境の世界で残す価値のある唯一の部分です。二人が衝突しかけていると気づく瞬間。
バージョニング、URL が何を動かしているか語るように#
共有環境がひとつのとき、「ステージングに何が載ってる」は Slack の質問でした。複数になれば環境の属性でなければならず、さもなければすべてのバグ報告が考古学から始まります。
- すべてのイメージがコミット SHA を持ち、アプリがそれを公開する。
fly deploy --build-arg GIT_SHA=... --build-arg GIT_BRANCH=...がイメージに環境変数として刻み、/api/version/が環境名、Fly アプリ、イメージ参照と一緒に返します(上のスクリーンショット参照)。「feature-profile-tagl-fa8832 で壊れてる」に対して誰もが最初にするのは、思っているコミットを動かしているかの確認です。最初のデモ環境はツールがコミットされる一コミット前の作業ツリーからデプロイされていて、エンドポイントがそう言いました。期待した SHA ではなく87c061b9。 ENVIRONMENT=$ENVがすべてのログ行と Sentry のタグにある。 ブランチのエラーが本番のエラー追跡を汚さず、ワンクリックで絞り込めます。- ブランチは SHA を、リリースはタグを持つ。
feature-payments-retr-3f9a1cにバージョン番号はありません。コミットがあります。ステージングと本番にはv1.42.0があります。 - モバイルアプリは URL ではなく最小 API バージョンを持つ。 dev メニューの URL フィールドがテスターが実機をブランチに向ける方法で、API スキーマバージョンを載せた
/versionエンドポイントが、アプリが理解できる相手と話しているかを知る方法です。
これで解決しないこと#
一緒でなければ意味をなさない二つの機能は解決しません。ブランチ環境はブランチひとつを見せます。答えは両方をフラグの裏でマージして main を見ることで、main を追いかける常設環境ひとつ(main-dev.marucommunity.com、マージのたびに再デプロイ)でできます。自分が残す唯一の長生きする非本番環境で、誰もそこへデプロイはしません。次のリリースが何になるかを見るためのものです。
登録済みコールバックを求めつつワイルドカードを受け付けないプロバイダーは解決しません。Firebase Auth は親ドメインを受け付けるので、marucommunity.com がすべての -dev ブランチホスト名を覆います。一部の OAuth や決済プロバイダーはそうではなく、その場合は Worker が最後に確保した環境へルーティングする共有ホスト名をひとつ置きます。小さなものにかかった小さなロックで、すべてにかかったロックよりずっとましです。
マイグレーションの人間側は解決しません。ツールは機械的な衝突を捕まえます。同じ二週間に二人が同じ概念を両立しない形でモデリングするのは捕まえられず、それを直す唯一の方法は、どちらかが気づくマイグレーションレビューです。
あなたの環境で確かめてみること#
共有の dev やステージングがあり、それを予約する Slack スレッドがあるなら:
- 完成したブランチが、作者以外の誰かに動いているところを見てもらえるまでどれだけ待ちますか? 一時間を超えるなら、そのロックの代金をデリバリー時間で払っていて、小さなチームならその大きな割合が待っています。
- 共有データベースはどれくらいの頻度でリセットされ、そのとき誰が作業を失いますか?
- 新しい開発者が初日に、誰にも何も頼まずに自分のブランチが動く公開 URL を手に入れられますか? 頼まなければならないものが何であれ、それが最初に自動化するものです。
- 新しい環境は現実的なデータから始まりますか? 空から始まるなら、最初に捕まえ損ねるバグは、空のテーブルでは平気で実物のテーブルでは四十分かかるマイグレーションです。
- 非本番のホスティングに、全員が忘れて一か月経ってもまだ存在するものがありますか? あるなら、何より先にスイーパーを書いてください。漏れは初日から始まります。
Slack の質問が消えるのは、人が尋ねるのをやめたからではなく、答えがいつも「使ってますよ、自分のを」だからです。