私がこれまで作ってきた画像アップロードには、いつも同じ綱引きがありました。アップロードする側は、写真をとにかく速く上げたい。私のほうは、サーバーで画像圧縮をかけ、サムネイルを作り、blurhashと色をいくつか抜き出し、入っていてはいけないメタデータを落として、アプリのほかの部分が期待する形で保存したい。私の要望リストをいちばん手軽に片づける方法はファイルをAPI経由で送ることで、それこそが相手の要望を遅くしている張本人なのです。
速くする方法は署名付きURLです。APIがURLに署名し、クライアントはそのURLにファイルを直接PUTして、バイト列はAPIにまったく触れません。定番の答えになっているのには、それだけの理由があります。ただ、そうした瞬間にバックエンドは蚊帳の外に置かれます。URLを渡したきり、何の音沙汰もありません。ファイルは届いたのか。想定どおりのサイズなのか。そもそもJPEGなのか。誰かがバックエンドに教えなければならないのですが、よくある選択肢はどれも、どこか物悲しいものです。クライアントが「終わりました」と知らせてくれるのを信じる(クライアントは嘘をつき、落ち、電波を失います)。バケットを定期的にポーリングする(遅くて無駄が多い)。最初に読まれたときに遅延処理する(最初の閲覧者が代償を払ううえ、ファイルをいつから安全に参照できるのかは相変わらず分かりません)。S3に直接アップロードするのが実際より難しそうに見えるのは、このせいです。アップロード自体は簡単です。足りないのは合図のほうです。
オブジェクト通知が、その合図です。私がFly.ioで使っているS3互換ストレージのTigrisは、バケットでオブジェクトが作成または削除されるたびに、小さなJSONをアプリにPOSTしてくれます。AWSで相当するのはS3イベント通知ですが、こちらは自分のコードに何かが届く前に、LambdaやSQSのキュー、EventBridgeを配線することになるのが普通です(SNSならHTTPSエンドポイントにPOSTできますが、その前にサブスクリプションの確認と署名の検証が待っています)。Tigrisの場合は、自分が持っているURLへのHTTPリクエスト1本で済みます。ストレージからバックエンドへの合図としては、これ以上ないくらい単純です。バケットがバックエンドと話せるように、こちらが橋を架けなくて済む。この機能はそのためにあります。
この記事では、流れを最初から最後まで追います。設定、イベントを受け取るDjangoのエンドポイント、サーバー側の処理を一切手放さない署名付きURLでのアップロード、そして落とし穴(CORS、サイズ制限、有効期限、複数ファイル)です。最後に、同じ合図を裏方の仕事に使った話をします。バケットに届いたログファイルがDiscordのアラートになり、何か月も面倒を見てきたcronジョブを消せた話です。
短い答え#
Tigrisのダッシュボードでバケットを開き、Settings、Object notificationsと進みます。アプリ上のHTTPSのURLを指定し、Basic認証を選びます(TigrisがAuthorizationヘッダーに載せて送るユーザー名とパスワードです。もうひとつの選択肢はBearerトークンです)。関心のあるキーについてだけ通知が来るよう、フィルターも追加します。フィルターはSQLに似た式で、「この記事で扱う3つのプレフィックスだけ」ならこう書きます。
WHERE `key` REGEXP "^(uploads/raw|logs/api|media)/"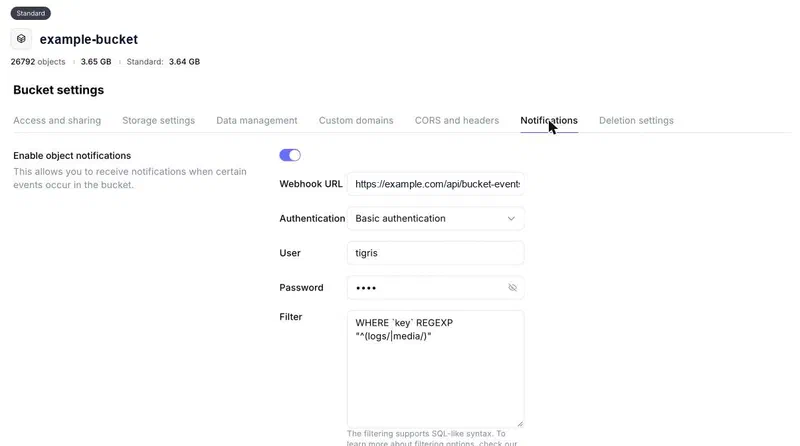
あとは変更があるたびに、Tigrisがこんなバッチを送ってきます。
{
  "events": [
    {
      "eventName": "OBJECT_CREATED_PUT",
      "eventTime": "2026-11-07T09:12:44Z",
      "bucket": "example-bucket",
      "object": { "key": "uploads/raw/1f3c.jpg", "size": 48213, "eTag": "9b2c…" }
    }
  ]
}目にするイベント名はOBJECT_CREATED_PUT、OBJECT_CREATED_MULTIPART、OBJECT_CREATED_COPY、OBJECT_DELETED、それにリネームとストレージ階層の移行です。エンドポイント側では認証を確認し、各イベントをキーのプレフィックスで振り分けて、10秒以内に2xxを返します。最初から織り込んでおくべきことが3つあります。配信は「少なくとも1回」なので、同じイベントがまた来ること。イベントはバッチで届くので、1回のリクエストに複数入っていること。そして順序どおりに届くとは限らないので、届いた順番から「最新」を読み取ってはいけないことです。
バケットのイベントを受け取るDjangoのWebhook#
ビューは、あえて退屈に作っています。認証を確認し、ボディをパースして、各イベントをルーターに渡すだけです。
import base64, hmac, json, logging
from django.conf import settings
from django.http import JsonResponse
from django.views.decorators.csrf import csrf_exempt
from django.views.decorators.http import require_POST

from .bucket_events import handle, parse

logger = logging.getLogger(__name__)

def _authorised(request, secret) -> bool:
    header = request.headers.get("Authorization", "")
    if not header.startswith("Basic "):
        return False
    try:
        user, _, password = base64.b64decode(header[6:]).decode().partition(":")
    except (ValueError, UnicodeDecodeError):
        return False
    return hmac.compare_digest(user.encode(), b"tigris") and hmac.compare_digest(
        password.encode(), secret.encode()
    )

@csrf_exempt
@require_POST
def bucket_webhook(request):
    secret = settings.BUCKET_WEBHOOK_SECRET
    if not secret:
        return JsonResponse({"error": "not configured"}, status=503)
    if not _authorised(request, secret):
        return JsonResponse({"error": "unauthorised"}, status=401)
    try:
        body = json.loads(request.body or b"{}")
    except ValueError:
        return JsonResponse({"error": "invalid json"}, status=400)
    for event in parse(body):
        try:
            handle(event)
        except Exception:
            logger.exception("bucket event failed: %s", event.key)
return JsonResponse({"ok": True})compare_digestを使っているのは、何を送られても照合にかかる時間を同じにするためです(比較はバイト列で行っています。文字列だと非ASCIIの入力で例外を投げるので、細工したヘッダーが401ではなく500を受け取ることになるからです)。たとえば立ち上げたばかりのステージング環境などでシークレットが未設定なら、エンドポイントはすべてを受け入れるのではなく、すべてを拒否します。そしてハンドラーが例外を投げても、ログに残したうえで200を返します。Tigrisは2xx以外なら何でもリトライしますが、リトライしても同じバグに当たるだけですし、その頃にはイベントはすでに確保済み(2つ下のセクションで説明します)なので、リトライしても何も起きません。直すきっかけになるのは、ログの1行のほうです。ただしこれは、失敗が決定的なもの、つまり何度やっても同じ結果になる場合の話です。ストレージの一時的なタイムアウトだと、イベントはそれきり消費されてしまいます。写真なら気にしなくて構いません。保存処理が自分で処理できるからです。でもログファイルのアラートは失われます。それが困るなら、exceptの中で確保を解放して500を返し、Tigrisにリトライさせてください。その代わり、本物のバグは直るまでリトライされ続けることになります。
プレフィックスで振り分ける#
バケットの中身はもともとプレフィックスで整理されているので、振り分けもそれでやるのが自然です。用途ごとに関数が1つ、テーブルに1行です。
HANDLERS = [
    ("uploads/raw/",   on_raw_photo),
    ("logs/api/",      on_api_log_file),
    ("media/",         on_media_change),
]

def handle(event):
    for prefix, fn in HANDLERS:
        if event.key.startswith(prefix):
            if claim(event):  # 後述
                fn(event)
            return
あとで4つ目を足したくなっても、関数と行を1つずつ増やすだけです。これが思っていた以上に気に入っています。
「少なくとも1回」は「2回かもしれない」#
エンドポイントの応答が遅かったりエラーを返したりすると、Tigrisはリトライします。そして多くのWebhook送信側と同じく、イベントが1回しか届かないという保証はありません。そこでハンドラーを動かす前に、(key, eTag, eventName)でイベントを確保します。ポイントはeTagです。ファイルが上書きされれば新しいeTagを持つ新しいバージョンなので、もう一度処理すべきです。一方、同じバージョンの重複は処理すべきではありません。
from django.core.cache import cache

def claim(event, ttl=7 * 24 * 3600) -> bool:
    k = f"bucket-event:{event.name}:{event.key}:{event.etag}"
return cache.add(k, 1, ttl) # 誰かが先に確保していればFalsecache.addはキーがまだ存在しないときだけ値をセットします。Redisではこれがアトミックなので、同じリトライを受け取った2台のマシンが両方とも勝つことはありません。本番ではRedisがフラッシュされても生き残るようにデータベースのリースを使っていますが、考え方はまったく同じです。
画像はS3に直接アップロード、パイプラインはそのまま#
ここまでの配管が報われるのは、この部分です。
以前は、出品用の写真を選ぶとアプリがそれを手元に保持し、投稿ボタンを押した時点で全部をbase64でAPIに送っていました。APIはリサイズし、サムネイルを作り、色とblurhashを計算して、それからようやく応答します。遅い回線で写真が10枚もあると、スピナーをずいぶん長く眺めることになります。それに、base64の写真を10枚抱えたリクエストは、APIサーバーがメモリに抱えるには大きくて遅いボディです。実はそれが、私が写真を小さく抑え続けていたひそかな理由でした。
今は4つのステップになり、そのすべてがバックエンドに伝わります。
1. クライアントが写真を縮小し、アップロード枠を要求する#
アプリは今でも端末上でリサイズします。サーバーが保持する長辺(1080px)に合わせ、品質0.7のJPEGにします。このリサイズはユーザーの通信量のためであって、それ以外の理由はありません。そのうえで、APIにアップロード枠を要求します。
import uuid
from datetime import timedelta
import boto3
from django.utils import timezone

s3 = boto3.client("s3", endpoint_url="https://fly.storage.tigris.dev")
BUCKET = "example-bucket"

def create_upload_slot(user):
    public_id = uuid.uuid4()
    key = f"uploads/raw/{public_id}.jpg"
    upload = PhotoUpload.objects.create(
        user=user,
        public_id=public_id,
        raw_key=key,
        expires_at=timezone.now() + timedelta(days=2),
    )
    url = s3.generate_presigned_url(
        "put_object",
        Params={"Bucket": BUCKET, "Key": key, "ContentType": "image/jpeg"},
        ExpiresIn=15 * 60,
    )
    return {
        "upload_id": str(upload.public_id),
        "url": url,
        "method": "PUT",
        "headers": {"Content-Type": "image/jpeg"},
        "expires_in": 15 * 60,
    }
枠は、ファイルになる前にまず1行のレコードです。だからサーバーは、誰が要求したのか、いつ期限が切れるのか、そして後になって実際に使われたのかを知ることができます。
2. クライアントがバケットに直接PUTする#
const slot = await api.post("/photo-uploads/");
const res = await fetch(slot.url, {
  method: slot.method,
  headers: slot.headers,
  body: blob,
});
if (!res.ok) throw new Error("upload refused");
// 保存時のためにslot.upload_idを控えておく
APIはバイト列を一切見ません。ブラウザからでも、React Nativeからでも、ネイティブアプリからでも同じです。唯一の違いは、ブラウザの場合はバケットにCORSルールが必要なことで、これは後述の落とし穴で触れます。
3. Tigrisがバックエンドに知らせ、パイプラインが動く#
数秒のうちにTigrisがuploads/raw/…のOBJECT_CREATED_PUTをPOSTしてきて、ハンドラーがbase64経路でずっと使ってきたのと同じ画像パイプラインを回します。ユーザーがまだタイトルを入力しているあいだにです。
from io import BytesIO
from PIL import Image, ImageOps
from django.core.files.base import ContentFile
from django.utils import timezone
import blurhash

MAX_BYTES = 15 * 1024 * 1024

def on_raw_photo(event):
    if not event.name.startswith("OBJECT_CREATED"):
        return
    if event.size > MAX_BYTES:
        s3.delete_object(Bucket=event.bucket, Key=event.key)
        return
    upload = PhotoUpload.objects.filter(raw_key=event.key, processed_at=None).first()
    if upload is None:
        return
    data = s3.get_object(Bucket=event.bucket, Key=event.key)["Body"].read()
    process(upload, data)

def to_webp(im, longest, quality):
    im = im.copy()
    im.thumbnail((longest, longest))
    buf = BytesIO()
    im.save(buf, "WEBP", quality=quality, icc_profile=im.info.get("icc_profile"))
    return ContentFile(buf.getvalue())

def process(upload, data):
    with Image.open(BytesIO(data)) as im:
        im = ImageOps.exif_transpose(im).convert("RGB")
        im.thumbnail((1080, 1080))
        upload.width, upload.height = im.size
        upload.dominant_color = "#%02x%02x%02x" % im.resize((1, 1)).getpixel((0, 0))
        upload.image.save(f"{upload.public_id}.webp", to_webp(im, 1080, 80), save=False)
        upload.thumbnail.save(f"{upload.public_id}_t.webp", to_webp(im, 320, 70), save=False)
        upload.blurhash = blurhash.encode(im.resize((32, 32)), 4, 3)
    upload.processed_at = timezone.now()
upload.save()on_raw_photoの最初の行は、見た目以上に大事です。ルーターはuploads/raw/配下のイベントをすべてここに送ってきます。孤立ファイルの掃除処理による削除も、サイズチェック自身による削除も含めてです。消えたキーにget_objectしても、例外が返ってくるだけです。
つまりクライアント側の縮小は、あくまで回線のためだけのものでした。フォーマット(WebP)も、サイズも、サムネイルも、プレースホルダーも、保存する寸法も、決めるのは今でもサーバーです。Pillowで再エンコードするとEXIFブロックも落ちます。スマートフォンのカメラがGPS位置情報を書き込むのはそこなので、プライバシーのためのメタデータ除去はおまけで付いてきます。ICCプロファイルも同じ道をたどるところですが、そうなると広色域のスマートフォン写真の色が少し転ぶので、to_webpではそのまま引き継いでいます。ピクセル単位で元画像を残したいなら、クライアントで縮小しなければいいだけです。流れは同じで、PUTが大きくなるだけ。そして大きなPUTこそ、この設計が安くしてくれるものです。ひとつ注意点があります。iPhoneの元画像はHEICで、Pillowがこれを開けるのはpillow-heifを入れたときだけです。
4. 保存時に写真を紐づけ、Webhookは待たない#
投稿ボタンが押されたときのリクエストには、画像データの代わりにupload_idsが入っています。サーバーはそれぞれを調べ、結果は3通りに分かれます。
def take(user, upload_ids):
    uploads = list(PhotoUpload.objects.filter(
        user=user, public_id__in=upload_ids, expires_at__gt=timezone.now()
    ))
    if len(uploads) != len(set(upload_ids)):     # 期限切れか、この人のものではない
        raise UploadNotReadyError(upload_ids)
    for upload in uploads:
        if upload.processed_at is None:          # Webhookがまだ届いていない
            data = read_raw(upload)              # PUTが届いていなければNone
            if data is None:
                raise UploadNotReadyError(upload.public_id)
            process(upload, data)
    return uploads
通知がすでに処理を済ませていれば、処理済みのファイルをそのまま紐づけます。ファイルはバケットにあるのに通知がまだ届いていなければ、保存処理がその場でインラインで処理します。だから投稿がWebhookを待つことはありません。通知は先回りであって、依存先ではないのです。そしてファイルがそもそも存在しない場合や、IDが期限切れだったり他人のものだったりする場合は、保存はバリデーションエラーを返し、アプリが少し待ってリトライします。アプリは自分のPUTが終わるのを待ってから送信するので、実際にはめったに起きません。
これを安定させるために効いた細かい点がいくつかあります。枠はユーザーのものなので、サーバーは同じ人が作成したアップロードIDしか受け付けません。そうしないと、IDを見かけた誰でも、あなたの写真を自分の出品に付けられてしまいます。すべてにフォールバックがあります。枠の要求に失敗した、PUTが拒否された、APIが古いバージョンだった、といった場合、アプリは従来どおりbase64で送ります。アップロード経路を使うのは新しい写真のすべてに枠があるときだけなので、1つの投稿の写真は全部アップロードか全部base64かのどちらかになり、並び順も1つのリストのまま保たれます。そして孤立したアップロードは期限切れになります。写真を選んだものの途中でやめる人はいるので、どこにも紐づかなかったアップロードは2日後に期限切れになり、既存の孤立メディアの掃除処理がファイルを片づけます。
署名付きURLアップロードの落とし穴:CORS、サイズ制限、有効期限、複数ファイル#
署名付きURLでのアップロードでつまずくことの大半は、通知が飛ぶより前の段階で起きます。1ページにまとめておきたいものを挙げます。
CORSはブラウザだけの話#
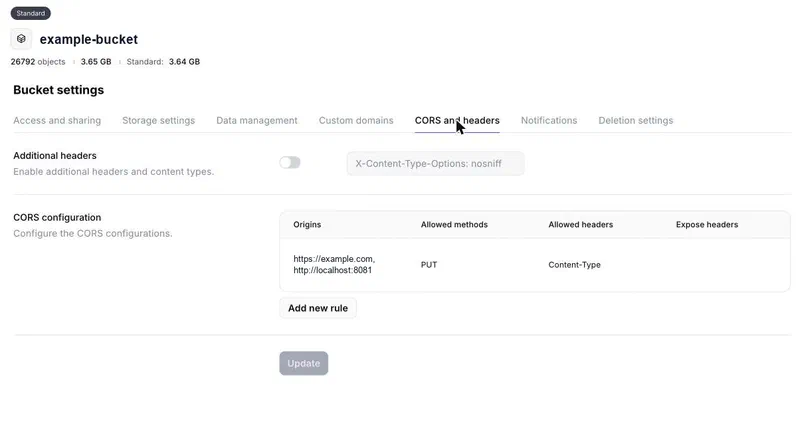
ネイティブアプリは気にしません。ブラウザはPUTの前にプリフライトのOPTIONSをバケットに送り、バケットのCORSルールがあなたのオリジンからのPUTをContent-Typeヘッダー付きで許可していなければ、アップロードはCORSエラーで失敗します。Tigrisは標準のS3 CORS設定をそのまま受け付けるので、ルールの書き方はAWSと同じです。署名付きPUTがcurlからは動くのにページからは動かないとき、最初に確認すべきはこれです。
Content-Typeは署名の一部#
ContentTypeを含めて署名すると、クライアントはそのヘッダーを寸分違わず送らなければならず、さもなければバケットは403のSignatureDoesNotMatchを返します。枠がURLと一緒にヘッダーも返しているのはそのためです。意図して署名に含めるのはいいのですが、それで何が手に入るのかは知っておいてください。強制されるのはヘッダーであって中身ではないので、image/jpegと名乗ったPDFは通ります。本当のチェックはパイプラインです。Pillowは画像でないものを開こうとせず、レコードが処理済みになることもありません。
サイズ制限#
署名付きPUT URLにはサイズ制限がありません。バイト列が届く前に確実に止めたいなら、content-length-rangeのポリシー条件を付けた署名付きPOSTがそれをやってくれます。私はそこまでしませんでした。通知にオブジェクトのsizeが入っているからです。ハンドラーは上限を超えるものを読む前に削除し、保存時の経路は判別できるよう上限プラス1バイトまでしか読みません。アプリが送るのは数百キロバイトで、15メガバイト近いものはうちのものではありません。
有効期限#
時計は2つあります。署名付きURLの有効期間は15分です。PUT 1回には十分で、漏れたURLがすぐに使い物にならなくなる程度には短い長さです。枠のレコードは2日間有効で、写真を選んでから端末を置き、翌日に出品を仕上げる、という使い方をカバーします。クライアントは保留中のアップロードを1日経ったら古いものとみなし、祈るのではなく新しい枠を取り直します。
複数ファイルと、もっと大きなファイル#
ファイル1つに枠1つです。写真が10枚なら枠が10個、並列のPUTが10本で、それぞれに進捗があります(XMLHttpRequestならupload.onprogressが使えます。fetchにはありません)。巨大なbase64のPOST 1本では手に入らないものです。数メガバイトを超えるならマルチパートを使います(パートは最低5 MiBなので、それをはるかに超えるファイル向けです)。サーバーでマルチパートアップロードを作成し、upload_partごとに署名し、パートが揃ったら完了させます。アップロードが完了した時点でTigrisがOBJECT_CREATED_MULTIPARTを送ってくるので、同じハンドラーが動き、ほかには何も変わりません。
順序は保証されない#
イベントは順序どおりに届くとは限りません。オブジェクトが複数のリージョンで書き込まれていることがあるからです。アップロードでは問題になりません。キー1つにイベント1つです。上書きされるキーについては、Webhookが届いた順番ではなく、eTagとオブジェクトのLast-Modifiedを信じてください。
同じ合図をログにも:Discordへのアラート#
バケットがバックエンドと話せるようになれば、そこに届くものには何でも同じやり方で反応できます。2つ目に向けた先はログでした。
アプリのログは、小さなgzipファイルとしてバケットに送られています。アプリごとにだいたい5分に1ファイルです。今年の大半は、15分おきのcronで動くGitHub Actionsのワークフローが、DuckDBでそのアーカイブの直近20分を読み、遅いリクエストの行を見つけて、Discordにまとめを投稿していました。理屈の上では問題ありません。ところが実際には、GitHubのスケジュール実行はプラットフォームが混んでいると時間どおりに動きません。「15分おき」はむしろ「数時間おき」で、やっと動いたと思えば処理する範囲が広すぎて、たまにメモリ不足で落ちていました。実行の合間に取りこぼさないよう重ねておいた時間範囲のせいで、同じ遅いリクエストが2回出てくることもありました。「遅いリクエストがあったら教えて」のためにしては、ずいぶん大がかりな仕掛けです。
今は各ログファイルを、届いた時点で1回だけ読みます。gzipで数キロバイトです。ハンドラーはそこから遅いリクエストの行を抜き出し、数が多いか、極端に遅いものが1件あれば、Discord webhook経由でチャンネルにまとめを投稿します。1つのファイルに5xxレスポンスが集中していた場合も同じです。PythonからDiscord webhookを叩くのは、呼び出し1回です。
import requests
from django.conf import settings

def discord_alert(text: str) -> None:
    requests.post(
        settings.DISCORD_WEBHOOK_URL,
        json={"content": text[:1900]},  # Discordのメッセージ上限は2000文字
        timeout=5,
    )
cronも、範囲の重なりも、重複もありません。アラートは、GitHubの手が空いたときではなく、リクエストから数分以内に届きます。あのActionはもうありません。
どうせファイルを開いているので、中身(エラー、警告、ヘルスチェック)を数えて、1時間ごとの集計テーブルにも書き込んでいます。以前は日次サマリーのたびにアーカイブを丸1日分スキャンしていました。今は数百行を読むだけで、集計に抜けがあるときだけアーカイブにフォールバックします。
削除の見張り#
これは計画していたわけではなく、OBJECT_DELETEDイベントが手に入ったことで自然に生まれました。メディアファイルが削除されると、ハンドラーはそれを参照している行がまだ残っていないかを確認します。残っていたら、それはどこかのバグ(あるいはバケットのコンソールで指がすべった誰か)です。そこでそのカラムをクリアして、アプリが壊れた画像ではなくプレースホルダーを表示するようにし、報告を上げます。
1時間あたりの削除数も数えています。通常のハウスキーピングで消えるのはせいぜい数件です。もし1時間に数百件も消えるようなことがあれば、ユーザーから「写真が真っ白」と報告が来てからではなく、起きているその最中に知りたいのです。
知っておくとよいこと#
応答は速く。Tigrisが1回の配信に与える時間は10秒です。5KBのログファイルを読んだり、スマートフォンの写真を1枚処理したりするぶんには収まります。それより長くかかりそうなものはキューに渡してビューは200を返すようにしないと、Tigrisがタイムアウトしてリトライし、また重複排除の世界に逆戻りです。
フィルターはバケット側で。私のログ転送は、アプリごとに数分おきに永遠にファイルを書き続けます。関心があるのが1つのプレフィックスだけなら、通知のフィルターでそう宣言しておけば、それ以外のことでアプリが起こされずに済みます。
テストは偽のボディで。ペイロードは小さくて安定しているので、テストでは正しいAuthorizationヘッダーを付けてビューにJSONをPOSTし、ハンドラーが何をしたかをアサートします。本物のストレージは関わりません。
初日から頼り切りにしない。ここで挙げた用途にはどれもフォールバックがあります。保存処理は自分で写真を処理できますし、日次サマリーは今でもアーカイブをスキャンできますし、アプリは今でもbase64で送れます。通知のおかげでどれも速く安くなりましたが、Webhookが1つ届かなかったくらいで倒れるものはありません。
今週いちばん気持ちよかったのは、あのワークフローのファイルを消した瞬間でした。40行のYAML、Pythonスクリプト、リポジトリのシークレット2つ、そして定期的にやってくる「なんでアラートが鳴らなかったの?」がまとめて消え、代わりに残ったのは、小さなファイルが届いたらそれを1つ読むだけのハンドラー1つです。とはいえ、本題はアップロードのほうでした。写真はネットワークが許す限りの速さで上がり、その1枚1枚についてサーバーが今でも最終決定権を持ち、バケットとバックエンドのあいだに橋を架ける必要は誰にもありませんでした。バケットが、何が起きたかを自分で言ってくれるようになったからです。