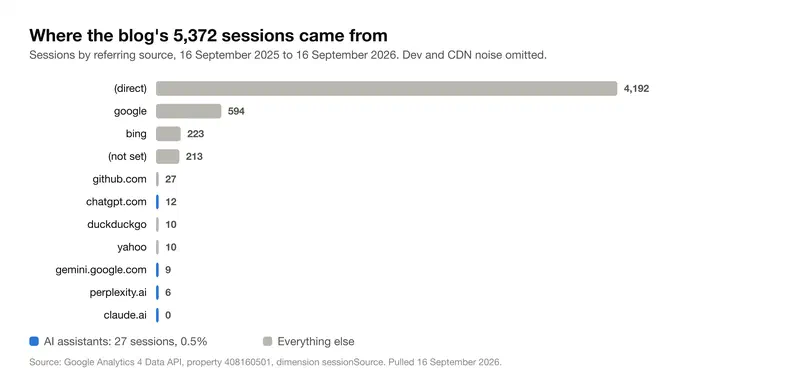
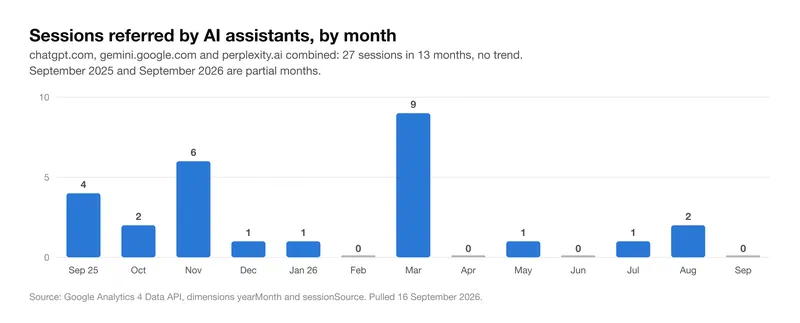
이 블로그의 검색 유입은 2년쯤 제자리이고, 이제는 움직이길 기대하지도 않습니다. 그래서 대신 방문자가 어디서 오는지, 그 안에 AI 어시스턴트도 있는지를 들여다봤습니다. 있긴 합니다. 간신히요. 2026년 9월 16일까지 열두 달 동안 Analytics가 센 세션은 5,372개였습니다. 그중 AI 어시스턴트에서 온 건 27개. chatgpt.com에서 12개, gemini.google.com에서 9개, Perplexity에서 6개, claude.ai에서는 하나도 없었습니다. 0.5퍼센트죠. 다만 ChatGPT에서 온 방문자는 좋은 쪽이었습니다. 직접 유입이 평균 27초, 구글이 3분 머무는 동안 이쪽은 평균 5분을 머물렀습니다. 이미 답을 읽고 자세한 내용을 보러 온 사람들이니까요.
그래서 작은 블로그가 그런 답변의 출처로 뽑히려면 뭐가 필요한지 시간을 좀 들여 봤습니다. 이 글은 제가 이 사이트에 한 일과, 로그가 그에 대해 뭐라고 하는지입니다. 숫자가 있는 곳에는 숫자를 적고, 추측인 곳은 추측이라고 밝히겠습니다. 초고에 있던 문장 세 개는 막상 들여다보니 틀린 것으로 드러났는데, 고친 흔적은 그대로 남겨 뒀습니다.
봇은 두 종류이고, 인용하는 쪽은 하나뿐입니다#
먼저 짚고 갈 것은 “AI 봇"이라는 게 사실 서로 다른 유저 에이전트를 쓰는 두 가지 다른 일이고, 한쪽을 막아도 다른 쪽에는 아무 영향이 없다는 점입니다.
학습용 크롤러는 다음 모델을 만들려고 페이지를 대량으로 긁어 갑니다. OpenAI는 GPTBot, Anthropic은 ClaudeBot이고, 구글은 Google-Extended 토큰으로, 애플은 Applebot-Extended로 제어하며, Common Crawl의 CCBot은 공개 데이터셋 대부분에 들어갑니다. 이들이 가져간 건 가중치가 되어 끝이고, 여러분에게 돌아오는 링크는 없습니다. 이쪽을 막아야 한다는 주장에는 일리가 있고, 저도 터무니없는 얘기라고는 생각하지 않습니다.
검색용 봇은 다른 종류입니다. 누군가 ChatGPT나 Claude, Perplexity에 질문하면 어시스턴트는 검색을 돌리고, 그 자리에서 페이지 몇 개를 가져와 읽은 다음, 인용을 달아 답을 씁니다. 그 요청은 OAI-SearchBot과 ChatGPT-User, Claude-SearchBot과 Claude-User, PerplexityBot과 Perplexity-User로 들어옵니다. 구글의 AI 오버뷰는 그냥 Googlebot을 쓰기 때문에 따로 끌 스위치 자체가 없습니다. 방문자를 돌려보내 주는 건 이쪽 봇들입니다. 목표가 인용되는 거라면 최적화 대상은 이쪽이고, GPTBot을 막아도 ChatGPT 검색 결과에는 어느 방향으로도 아무 영향이 없다는 건 알아 둘 만합니다.
이 사이트의 robots.txt는 Hugo 기본값 그대로, 전부 허용입니다.
User-agent: *
Allow: /
Sitemap: https://jared.lynskey.co.nz/sitemap.xml
검색용 봇은 들이고 학습용은 막는 식으로 나눌까 생각해 봤지만, 읽히는 게 존재 이유의 전부인 블로그에서 그럴 만한 가치는 없다고 결론 내렸습니다. 굳이 하자면 아래 블록처럼 될 겁니다. 이걸 보여 드리는 이유는 Cloudflare가 Googlebot에게 빈 페이지를 내줬다에서와 같은 교훈 때문입니다. 목록에는 회사가 아니라 봇 이름을 적어야 합니다. “OpenAI"라고 쓸 수 있는 줄은 없습니다.
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: CCBot
Disallow: /

User-agent: *
Allow: /
사이트가 Cloudflare 뒤에 있다면 확인할 게 하나 있습니다. 2025년 중반부터 거기서 새로 만드는 존은 기본으로 AI 크롤러를 막고, 봇 설정에는 기존 존에도 같은 걸 적용하는 원클릭 토글이 있습니다. 두 종류를 다 막습니다. 이 블로그는 지난주에 Cloudflare Pages로 옮겼기 때문에 이것도 제 확인 목록에 있었습니다. “AI 봇"이라는 말이 막아야 할 무언가처럼 들려서 켰다면, 인용도 같이 꺼 버린 겁니다. 그 뒤로 Cloudflare는 자기가 관리하는 robots.txt 파일에 search, ai-input, ai-train 플래그를 따로 둔 Content-Signal 줄을 쓰기 시작했습니다. 아무도 지킬 의무는 없지만 어휘는 제대로 골랐습니다. 위와 같은 구분을 벽이 아니라 선호로 표현한 거니까요.
실제로 문을 두드리는 건 누구인가#
Cloudflare로 옮긴 데는 부수 효과가 하나 있었습니다. 처음으로 모든 요청을 유저 에이전트별로 볼 수 있게 된 겁니다. 2026년 9월 13일부터 16일까지 나흘 동안 들어온 건 아래와 같습니다. 가짜는 걸러낸 숫자인데, 그 얘기는 곧 하겠습니다.
| 봇 | 요청 수 | 한 일 |
|---|---|---|
| ClaudeBot (학습용) | 1,777 | 이틀 동안 서로 다른 페이지 1,380개, 다섯 개 언어 전부, 거기에 robots.txt 37번 |
| meta-externalagent (학습용) | 1,748 | 같은 일을 하루 늦게 |
| OAI-SearchBot (ChatGPT 검색 인덱스) | 59 | 다섯 개 언어의 페이지들, 그리고 robots.txt 16번 |
| ChatGPT-User (답변 중 가져감) | 20 | Fly.io 콜드 스타트 글의 일본어판, Expo 업데이트 서버 글, 홈페이지 |
| Claude-User (답변 중 가져감) | 8 | 업데이트 서버 글, 연락처 페이지, 홈페이지 |
| PerplexityBot | 2 | iOS 디버깅 글, 영어판과 베트남어판 |
| Claude-SearchBot, Perplexity-User | 0 | |
| Googlebot / Bingbot / Applebot / CCBot | 168 / 71 / 45 / 28 |
눈에 띄는 게 두 가지 있습니다. 검색용 봇이 페이지 수십 개를 읽는 사이 학습용 크롤러는 전부를 두 번씩 읽었습니다. 그리고 검색용 봇은 아무거나 가져가지 않습니다. ChatGPT-User와 Claude-User 둘 다 이 사이트에서 가장 구체적인 글인 업데이트 서버 글을 집어 갔고, 콜드 스타트 글은 일본어판으로 가져갔습니다.
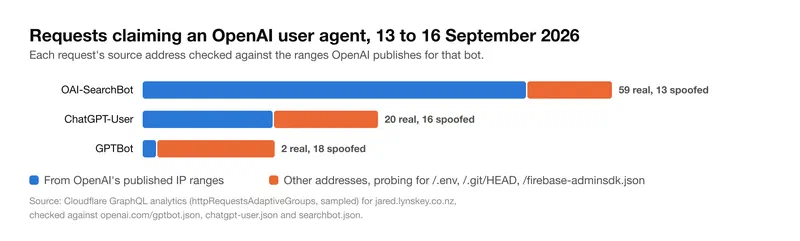
이제 가짜 얘기입니다. GPTBot이라고 주장한 요청 20개 중 18개는 OpenAI가 공개한 IP 대역 밖에서 왔고, /.env, /.git/HEAD, /firebase-adminsdk.json을 달라고 했습니다. “ChatGPT-User” 요청 36개 중 15개도 같은 부류였습니다. “PerplexityBot” 트래픽은 대부분 /id_ed25519를 원했습니다. 유저 에이전트는 누구나 보낼 수 있는 문자열이고, 취약점 스캐너들은 AI 봇 이름을 달면 그냥 통과된다는 걸 눈치챘습니다. OpenAI, Anthropic, Perplexity 모두 IP 대역을 공개합니다. 봇을 어느 방향으로든 특별 취급할 거라면 이름이 아니라 주소를 확인해야 합니다. 위 표의 20, 59, 8은 제대로 된 주소에서 온 요청만 센 숫자입니다.
페이지는 브라우저 없이도 읽혀야 합니다#
검색용 봇은 답변하는 그 시점에 타임아웃을 걸고 페이지를 가져오며, 대부분 JavaScript를 실행하지 않습니다. 번들이 로드되기 전까지 빈 div인 페이지는 그들이 읽지 않는 페이지입니다. Hugo는 완성된 HTML을 써 주니 이 블로그는 그걸 공짜로 얻고, 제가 더 영리한 무언가로 옮기고 싶었던 적이 한 번도 없는 주된 이유이기도 합니다. 제가 운영하는 마켓플레이스는 정반대 경우인 React Native 웹앱이라, 크롤러에게 제대로 된 문서를 주기까지 동적 렌더링 분기가 하나 필요했고, 그다음엔 그걸 조용히 되돌려 버린 캐싱 버그가 있었습니다. 위의 Cloudflare 글이 그 이야기입니다.
속도도 같은 식으로 셈에 들어가는데, 여기서 로그가 저를 바로잡았습니다. Cloudflare 뒤에 있는 정적 사이트는 가장 가까운 엣지에서 나간다고 넘겨짚고 있었거든요. 아닙니다. 이 블로그는 Cloudflare Pages에 있고, HTML은 캐시되지 않은 채 나가며, 서울에서 요청하면 응답이 로스앤젤레스에서 0.5초쯤 걸려 돌아옵니다. 타임아웃이 몇 초인 봇에게는 그래도 충분하지만, 제가 장담했을 법한 수십 밀리초는 아니고, 이걸 아는 것도 직접 재 봤기 때문입니다. 페이지 여섯 개로 답을 짜는 어시스턴트는 3초 걸리는 하나를 그냥 버립니다. 버렸다고 말해 주지도 않습니다.
문단 하나를 그대로 떼어 갈 수 있게 쓰기#
이 시스템들이 페이지를 쓰는 방식은 독자가 읽는 방식과 다릅니다. 페이지를 청크로 쪼개고, 청크마다 질문에 대해 점수를 매기고, 점수가 나오는 것을 인용합니다. 800단어에 걸쳐 요점을 향해 쌓아 올라가는 글은 모든 청크에서 점수가 낮습니다. 섹션마다 첫 문장에서 주장을 말하고 그다음에 뒷받침하는 글은 질문에 맞는 섹션에서 점수를 냅니다.
이게 어떤 기술적인 것보다 제가 여기 글을 쓰는 방식을 많이 바꿨습니다. 프런트매터의 description은 이제 읽어 보라고 낚는 문구가 아니라 글이 말하는 내용의 요약입니다. 어시스턴트가 보여 주는 게 description뿐인 경우가 많거든요. 섹션 제목은 그 섹션이 내리는 결론을 말합니다. 숫자는 차트가 아니라 단위와 함께 문장 안에 들어갑니다. 날짜는 풀어서 씁니다. 1년 뒤에 이 페이지를 읽는 모델에게 “지난주"는 아무 뜻도 없으니까요. 그리고 글 하나는 한 가지에 대해서만 씁니다.
나머지 절반은 인용할 만한 게 있느냐인데, 여기서는 데이터가 엇갈립니다. 로그를 보면 답변 시점에 봇이 가져가는 페이지는 구체적인 글들입니다. Fly.io 콜드 스타트, 업데이트 서버, iOS 디버깅. 네이버 크롤러는 Yeti이고 다음 크롤러는 Daumoa다, Fly.io 재시작은 504가 나는 30초짜리 구간이다, Cloudflare의 실시간 Brotli 압축은 제 번들에서 gzip보다 나쁘게 측정됐다. 이런 사실은 적혀 있는 곳이 많지 않아서, 그중 하나가 필요한 질문은 여기로 옵니다. 그런데 어시스턴트에서 클릭해 들어오는 사람들은 대부분 2023년과 2024년에 쓴 관리에 대한 글에 내려앉습니다. 글마다 한두 세션씩요. 구체적인 글은 기계가 읽고, 일반적인 글은 클릭을 받습니다. 이걸 깔끔하게 설명할 방법이 저한테는 없고, 지어내느니 그대로 보고하는 편을 택하겠습니다. 지렛대가 있다면 그건 여전히, 이번 주에 알아냈는데 검색했을 때는 찾을 수 없었던 그 구체적인 것을 적어 두는 겁니다. 기계가 실제로 읽는 건 그쪽이라는 게 로그에 보이니까요.
누가 썼는지 밝히고, 계속 같은 말을 하기#
페이지를 인용할지 결정하는 어시스턴트는 꼼꼼한 독자가 하는 것과 비슷한 일을 합니다. 누가 썼고, 언제 썼고, 내가 찾은 다른 것들과 맞아떨어지는가? 이 사이트에서 그 부분의 기계적인 처리는 대부분 테마가 해 줍니다. 모든 글에 저자, 게시일, 수정일이 든 Article 구조화 데이터가 붙고, 저자는 같은 GitHub와 LinkedIn 프로필로 링크된 Person입니다. 템플릿 몇 줄이지만 “페이지 하나"와 “이력이 있는 특정 사람이 쓴 페이지"의 차이가 거기서 납니다.
테마가 해 주지 않는 부분은 일관성입니다. 소개 페이지, llms.txt, LinkedIn 프로필, 모든 글 맨 위의 한 줄이 전부 같은 사람을 같은 경력으로 설명합니다. 뭔가 바뀌면 전부 바꿔야 하고, 아니면 깜빡한 하나가 틀린 하나가 됩니다. 까다롭게 들리지만, 한 페이지는 제가 엔지니어링 매니저라고 하고 다른 페이지는 프리랜서라고 하는 건 모델이 얼버무리거나 다른 사람을 고르게 만드는 바로 그런 종류의 모순입니다.
수정일도 정직해야 합니다. 내용이 바뀔 때 바뀌고, 그 외에는 손대지 않습니다. 신선해 보이려고 날짜를 올리는 건 한 번은 통하고 그다음엔 도메인 전체가 평가절하되는 종류의 일입니다.
llms.txt, 그리고 아무것도 읽지 않는다는 사실#
llms.txt는 2024년 9월에 나온 제안으로, 사이트 루트에 언어 모델에게 사이트 요약과 골라 놓은 링크 목록을 주는 Markdown 파일을 두자는 겁니다. 저는 올해 2월에 하나 추가했습니다. 제가 누구인지 한 문단, 그다음 관리, 인프라, 모바일, 커뮤니티 섹션이 있고, 글마다 제목, URL, 그 글이 내리는 결론 한 문장으로 된 한 줄이 있습니다. 바쁜 사람을 위해 쓴 목차처럼 읽힙니다.
단서는, 아무것도 이 파일을 읽지 않는다는 겁니다. 제가 가진 나흘치 로그에서 /llms.txt 요청은 제가 보낸 것뿐이었습니다. Common Crawl은 2026년 8월 크롤에서 이 사이트의 페이지 76개를 담아 갔지만 그 파일은 한 번도 가져가지 않았습니다. 주요 어시스턴트 중 이 파일을 읽는다고 밝힌 곳도 없습니다. 그러니 여기 있는 뭔가가 인용되는 이유가 이 파일은 아니고, 그런 이유로 누군가에게 권하는 것도 삼가겠습니다. 그래도 두 가지 이유로 두고 있습니다. 한 시간 들었는데, 글마다 실제로 뭘 결론 내리는지 한 문장씩 쓰는 일이 파일 자체보다 값어치가 있었습니다. 어떤 글이 아무것도 결론 내리지 않는지 보여 줬거든요. 그리고 사이트가 뭘 위한 곳인지 기계에게 말해 주는 유일한 페이지라서, 필요 없더라도 있는 편이 낫습니다. 손으로 쓰다 보니 깜빡해서 그 뒤로 어긋나긴 했는데, 그게 Hugo 출력 포맷으로 프런트매터에서 생성하자는 쪽의 논거입니다. 할 일 목록에 있습니다.
피드, 사이트맵, 그리고 다섯 개 언어#
재미없는 기본 설비도 여전히 중요합니다. 크롤러가 올라간 당일에 새 글을 찾는 건 사이트맵을 통해서고, 글이 바뀐 걸 아는 건 RSS를 통해서입니다. 둘 다 Hugo 기본값이라 신경 써 본 적이 없습니다. ClaudeBot은 이틀 동안 사이트맵을 36번 읽었고, 페이지 1,380개를 그렇게 빨리 찾아낸 것도 그 덕입니다.
언어는 중요할 거라고 예상하지 못했던 부분입니다. 여기 있는 건 전부 영어, 일본어, 한국어, 중국어 간체, 베트남어로 있고, 크롤러가 같은 글이라는 걸 알 수 있도록 alternate 링크가 붙어 있습니다. 크롤러는 이걸 사이트 다섯 개로 취급합니다. ClaudeBot의 크롤은 다섯 언어에 거의 고르게 나뉘었고, Common Crawl이 8월에 가져간 글 페이지 73개 중 영어판은 네 개뿐이었습니다. 어시스턴트는 질문받은 언어로 답하고 그 언어로 된 출처를 선호하기 때문에, Fly.io 콜드 스타트에 대한 한국어 질문은 영어 페이지를 즉석에서 번역한 것이 아니라 한국어 페이지로 답할 수 있고, ChatGPT가 실제로 가져간 것도 일본어 페이지였습니다. 조건은 번역이 그 언어로 쓴 것처럼 읽혀야 한다는 겁니다. 올해 초에 원어민 검토를 받아 가며 한 번 손본 건 사람 독자를 위해서였지만, 베트남어 페이지가 구경거리가 아니라 출처가 되는 것도 그 덕입니다.
측정할 수 있는 것#
추측을 그만두고 나니 생각보다 많았습니다. Cloudflare 무료 플랜은 유저 에이전트와 경로별 요청 로그를 한 번에 하루치씩 조회하게 해 주는데, 위의 봇 표는 거기서 나왔습니다. 리퍼러는 유료 플랜이 필요합니다. 리퍼러는 Google Analytics에 있고, 대시보드를 눈 찌푸리고 들여다보는 대신 API로 뽑아낸 게 맨 위의 숫자들입니다. 둘을 합치면 윤곽이 보입니다. 나흘 동안 검색용 봇은 OpenAI와 Anthropic 주소에서 페이지 90개쯤을 가져갔습니다. 지난 한 달 동안 ChatGPT에서 건너온 사람은 두 명입니다. 많이 읽히고, 가끔 인용되고, 클릭은 드물게. 페이지를 썼는데 클릭은 안 된 답변을 볼 방법은 여전히 제가 아는 한 없습니다. 가장 유용한 확인은 여전히 수동입니다. 내 글이 답하는 질문을 어시스턴트에게 물어보고 누구 페이지를 인용하는지 보는 거죠.
이 중에 하나만 남겨야 한다면 글쓰기 규칙입니다. robots.txt, 구조화 데이터, llms.txt는 오후 한나절 일이고 그러면 끝납니다. 섹션마다 주장을 먼저 말하도록 쓰는 것, 일반적인 것 대신 구체적인 것에 대해 쓰는 것은 습관이고, 페이지가 인용할 가치가 있는지를 결정하는 건 그 습관입니다. 두 번째는 주장하기 전에 재 보는 겁니다. 기계에게 신뢰받는 건 알고 보면 사람에게 신뢰받는 것과 많이 닮았습니다. 내가 누구인지 말하고, 내가 아는 걸 말하고, 매번 같은 방식으로 말하는 것.