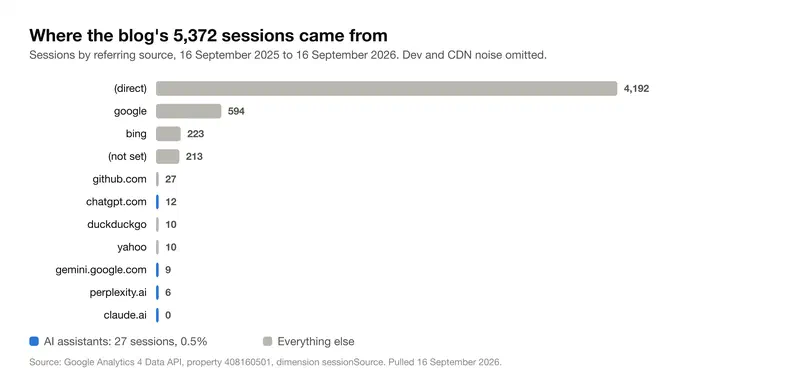
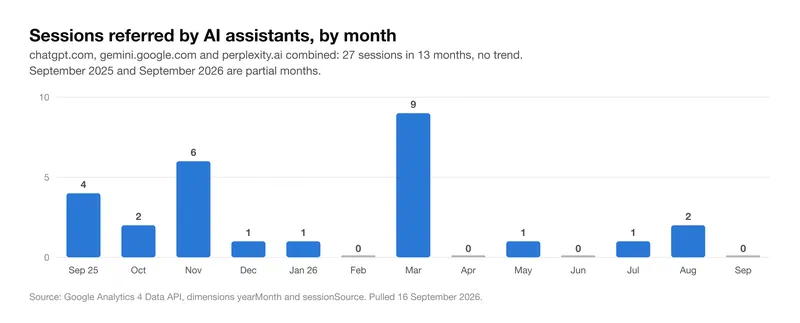
Lượng truy cập từ công cụ tìm kiếm vào blog này đã đứng yên vài năm nay, và tôi cũng thôi mong nó nhúc nhích. Nên thay vào đó tôi đi xem khách đến từ đâu, và trong số đó có các trợ lý AI (AI assistant) hay không. Có, nhưng chỉ vừa đủ để gọi là có. Trong mười hai tháng tính đến ngày 16 tháng 9 năm 2026, Analytics đếm được 5,372 phiên truy cập (session) ở đây. Hai mươi bảy phiên trong số đó đến từ một trợ lý AI: mười hai từ chatgpt.com, chín từ gemini.google.com, sáu từ Perplexity, và không có phiên nào từ claude.ai. Nửa phần trăm. Nhưng khách đến từ ChatGPT lại là loại khách tốt. Họ ở lại trung bình năm phút, so với 27 giây của lượt truy cập trực tiếp và ba phút của khách từ Google, vì họ đã đọc xong câu trả lời rồi và muốn xem chi tiết.
Nên tôi đã dành thời gian tìm hiểu xem một blog nhỏ làm thế nào để được chọn làm nguồn cho những câu trả lời đó. Bài này là những gì tôi đã làm trên trang này, cùng với những gì log nói về chuyện đó. Chỗ nào có số thì tôi đưa số, chỗ nào đang đoán thì tôi nói rõ là đoán. Có ba câu trong bản nháp đầu hóa ra sai khi tôi thực sự nhìn vào số liệu, và tôi để nguyên các chỗ sửa trong bài.
Hai loại bot, và chỉ một loại trích dẫn bạn#
Điều đầu tiên cần phân định rõ là “bot AI” thực ra là hai công việc khác nhau với hai bộ user agent khác nhau, và chặn loại này chẳng ảnh hưởng gì đến loại kia.
Trình thu thập dữ liệu (crawler) huấn luyện kéo trang về hàng loạt để xây mô hình tiếp theo. Của OpenAI là GPTBot, của Anthropic là ClaudeBot, của Google được điều khiển qua token Google-Extended, của Apple qua Applebot-Extended, còn CCBot của Common Crawl thì cấp dữ liệu cho phần lớn các bộ dữ liệu mở. Những gì chúng lấy đi cuối cùng trở thành trọng số (weights) của mô hình, không có đường dẫn nào trỏ ngược về bạn. Chặn những bot này là có lý, và tôi không cho đó là chuyện vớ vẩn.
Bot truy xuất (retrieval bot) là loại còn lại. Khi ai đó hỏi ChatGPT, Claude hay Perplexity một câu, trợ lý sẽ chạy một lượt tìm kiếm, tải về ngay lúc đó một nhúm trang, đọc chúng, rồi viết câu trả lời kèm trích dẫn (citation). Những lượt tải đó đến dưới tên OAI-SearchBot và ChatGPT-User, Claude-SearchBot và Claude-User, PerplexityBot và Perplexity-User. AI Overviews của Google thì dùng Googlebot thường, nên chẳng có công tắc riêng nào cho chúng cả. Đây mới là những bot đưa người đọc quay lại với bạn. Nếu mục tiêu là được trích dẫn thì đây là những bot bạn đang tối ưu cho, và cũng nên biết rằng chặn GPTBot không ảnh hưởng gì đến kết quả tìm kiếm của ChatGPT, theo cả hai chiều.
robots.txt của trang này là bản mặc định của Hugo, tức là cho phép tất cả:
User-agent: *
Allow: /
Sitemap: https://jared.lynskey.co.nz/sitemap.xml
Tôi đã cân nhắc tách nó ra, cho bot truy xuất vào và giữ bot huấn luyện ở ngoài, rồi quyết định là không đáng làm với một blog mà mục đích duy nhất là để được đọc. Nếu tôi muốn vậy thì nó sẽ trông như khối bên dưới. Lý do đưa nó ra đây cũng là bài học trong bài Cloudflare trả về cho Googlebot một trang trống: danh sách phải gọi tên bot, không phải tên hãng. Không có dòng nào bạn viết ra được để nói “OpenAI”.
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: CCBot
Disallow: /

User-agent: *
Allow: /
Một điều cần kiểm tra nếu trang nằm sau Cloudflare. Từ giữa năm 2025, các zone mới ở đó chặn trình thu thập dữ liệu AI theo mặc định, và có một nút bật một chạm trong phần cài đặt bot làm điều tương tự với các zone cũ. Nó chặn cả hai loại. Blog này vừa chuyển sang Cloudflare Pages tuần trước, nên việc đó có trong danh sách của tôi. Nếu bạn bật nó lên vì “bot AI” nghe như thứ nên chặn ở ngoài, thì bạn cũng vừa tắt luôn việc được trích dẫn. Cloudflare sau đó đã bắt đầu ghi một dòng Content-Signal vào các tệp robots.txt mà họ quản lý, với ba cờ riêng search, ai-input và ai-train. Không ai bị bắt buộc phải tuân theo, nhưng đó là đúng bộ từ vựng: cùng cách phân chia như trên, diễn đạt như một nguyện vọng thay vì một bức tường.
Thực sự thì ai đang gõ cửa#
Việc chuyển sang Cloudflare có một tác dụng phụ: lần đầu tiên tôi nhìn thấy được từng request theo user agent. Dưới đây là những gì đã ghé vào trong bốn ngày từ ngày 13 đến ngày 16 tháng 9 năm 2026, sau khi đã loại bỏ các bot giả mạo (spoof), phần này tôi sẽ nói ngay sau đây.
| Bot | Số request | Nó đã làm gì |
|---|---|---|
| ClaudeBot (huấn luyện) | 1,777 | 1,380 trang khác nhau trong hai ngày, đủ cả năm ngôn ngữ, cộng thêm 37 lần đọc robots.txt |
| meta-externalagent (huấn luyện) | 1,748 | Y hệt như trên, chậm hơn một ngày |
| OAI-SearchBot (chỉ mục tìm kiếm của ChatGPT) | 59 | Các trang ở cả năm ngôn ngữ, và robots.txt mười sáu lần |
| ChatGPT-User (tải về lúc đang trả lời) | 20 | Bài tiếng Nhật về khởi động nguội (cold start) trên Fly.io, bài về máy chủ cập nhật Expo, trang chủ |
| Claude-User (tải về lúc đang trả lời) | 8 | Bài về máy chủ cập nhật, trang liên hệ, trang chủ |
| PerplexityBot | 2 | Bài về gỡ lỗi (debug) iOS, bản tiếng Anh và bản tiếng Việt |
| Claude-SearchBot, Perplexity-User | 0 | |
| Googlebot / Bingbot / Applebot / CCBot | 168 / 71 / 45 / 28 |
Có hai điều nổi bật. Các bot huấn luyện (training crawler) đọc hết mọi thứ, tới hai lần, trong khoảng thời gian mà các bot truy xuất chỉ đọc vài chục trang. Và bot truy xuất không tải về một cách ngẫu nhiên: cả ChatGPT-User lẫn Claude-User đều nhắm vào bài về máy chủ cập nhật, là bài cụ thể nhất trên trang này, còn bài về khởi động nguội bản tiếng Nhật thì được tải về đúng bằng tiếng Nhật.
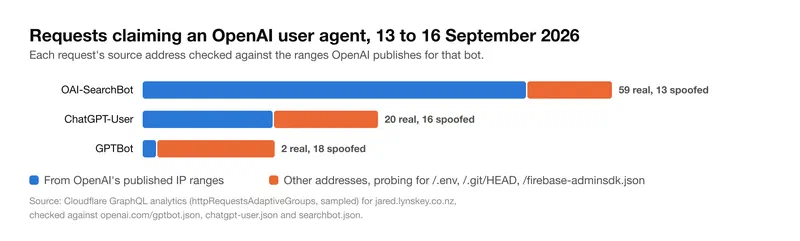
Giờ đến phần giả mạo. Trong 20 request tự xưng là GPTBot, có 18 đến từ những địa chỉ nằm ngoài dải địa chỉ IP (IP range) mà OpenAI công bố, và chúng đòi /.env, /.git/HEAD và /firebase-adminsdk.json. Mười lăm trong 36 request “ChatGPT-User” cũng là kiểu đó. Phần lớn lưu lượng “PerplexityBot” thì muốn lấy /id_ed25519. User agent chỉ là một chuỗi ký tự mà ai cũng gửi được, và các công cụ quét lỗ hổng đã nhận ra rằng cứ mang tên bot AI là được cho qua. OpenAI, Anthropic và Perplexity đều công bố dải địa chỉ IP của mình. Nếu bạn định đối xử đặc biệt với một bot, dù là cho vào hay chặn lại, hãy kiểm tra địa chỉ chứ đừng tin cái tên. Các con số 20, 59 và 8 ở trên là những request đến từ đúng địa chỉ.
Trang phải đọc được mà không cần trình duyệt#
Bot truy xuất tải trang ngay lúc trả lời, có giới hạn thời gian chờ (timeout), và phần lớn không chạy JavaScript. Một trang chỉ là cái div rỗng cho đến khi bundle tải xong là một trang chúng không đọc. Hugo xuất ra HTML hoàn chỉnh, nên blog này có sẵn điều đó mà không phải làm gì, và đó là lý do chính tôi chưa bao giờ bị cám dỗ chuyển nó sang thứ gì đó thông minh hơn. Sàn mua bán tôi đang vận hành là trường hợp ngược lại, một ứng dụng web React Native, và để trình thu thập dữ liệu nhận được một tài liệu thực sự ở đó, tôi đã phải làm một nhánh dựng trang động (dynamic rendering), rồi dính một lỗi bộ nhớ đệm (cache) lặng lẽ phá hỏng nó. Bài Cloudflare ở trên chính là câu chuyện đó.
Tốc độ cũng được tính theo cách tương tự, và ở chỗ này log đã sửa lưng tôi. Tôi vẫn đinh ninh một trang tĩnh nằm sau Cloudflare thì được phục vụ từ máy chủ biên (edge) gần nhất. Không phải vậy. Blog này chạy trên Cloudflare Pages, HTML được trả ra mà không qua bộ nhớ đệm, và từ Seoul thì phản hồi quay về từ Los Angeles mất khoảng nửa giây. Với một bot có thời gian chờ vài giây thì vẫn ổn, nhưng nó không phải vài chục mili giây như tôi suýt viết ra, và tôi biết được chỉ vì đã đo. Một trợ lý đang ghép câu trả lời từ sáu trang sẽ bỏ cái trang mất ba giây, và nó không nói cho bạn biết là nó đã bỏ.
Viết sao cho nhấc nguyên một đoạn ra được#
Cách các hệ thống này dùng một trang không giống cách một người đọc dùng. Chúng cắt trang thành từng khúc (chunk), chấm điểm từng khúc so với câu hỏi, rồi trích những khúc điểm cao. Một bài dẫn dắt suốt tám trăm chữ mới đến ý chính thì khúc nào điểm cũng thấp. Một bài mà mỗi phần nêu luận điểm ngay câu đầu rồi mới chứng minh thì phần khớp với câu hỏi sẽ ghi điểm.
Điều đó thay đổi cách tôi viết ở đây nhiều hơn bất cứ thứ gì thuộc về kỹ thuật. Phần description trong front matter giờ là tóm tắt bài nói gì, không phải câu mồi để bạn bấm vào đọc, vì description thường là phần duy nhất trợ lý hiển thị. Tiêu đề mục nói thẳng mục đó kết luận gì. Con số đi kèm đơn vị ngay trong câu thay vì nằm trong biểu đồ. Ngày tháng được viết ra đầy đủ, vì “tuần trước” chẳng có nghĩa gì với một mô hình đọc trang này một năm sau. Và một bài chỉ nói về một chuyện.
Nửa còn lại là phải có thứ đáng để trích, và ở chỗ này số liệu lại không thuận một chiều. Trong log, những trang mà bot tải về lúc trả lời là những bài cụ thể: khởi động nguội trên Fly.io, máy chủ cập nhật, gỡ lỗi iOS. Trình thu thập dữ liệu của Naver tên là Yeti và của Daum là Daumoa, một lần khởi động lại máy trên Fly.io là một khoảng ba mươi giây trả lỗi 504, Cloudflare nén Brotli tại chỗ đo trên bundle của tôi còn tệ hơn gzip. Những dữ kiện đó không được ghi lại ở nhiều nơi, nên câu hỏi nào cần đến một trong số chúng sẽ rơi vào đây. Nhưng những người bấm từ trợ lý sang thì phần lớn lại rơi vào các bài về quản lý từ năm 2023 và 2024, mỗi bài một hai phiên. Bài cụ thể thì máy đọc. Bài chung chung thì người bấm. Tôi không có lời giải thích gọn gàng nào cho chuyện đó, và tôi thà kể lại đúng như vậy còn hơn bịa ra một lý do. Đòn bẩy, nếu có, vẫn là viết ra cái điều cụ thể bạn vừa phát hiện tuần này mà lúc tìm kiếm bạn không thấy đâu, vì đó rõ ràng là thứ máy đang đọc.
Nói rõ ai viết, và lần nào cũng nói như nhau#
Một trợ lý khi cân nhắc có trích dẫn một trang hay không đang làm gần giống một người đọc cẩn thận: ai viết cái này, viết khi nào, và nó có khớp với mọi thứ khác tôi đã tìm thấy không? Phần cơ chế của việc đó trên trang này chủ yếu là do theme làm. Mỗi bài đều mang dữ liệu có cấu trúc (structured data) kiểu Article với tác giả, ngày đăng và ngày sửa, và tác giả là một Person với liên kết đến cùng hồ sơ GitHub và LinkedIn. Đó là vài dòng trong template, và là khác biệt giữa “một trang” với “một trang của một người có tên tuổi và có quá trình”.
Phần không phải theme làm là sự nhất quán. Trang giới thiệu, llms.txt, hồ sơ LinkedIn và dòng ở đầu mỗi bài đều mô tả cùng một người với cùng một quá trình làm việc. Khi có gì thay đổi thì tất cả cùng đổi, nếu không, cái tôi quên sẽ thành cái sai. Nghe có vẻ tỉ mẩn, nhưng một trang nói tôi là quản lý kỹ thuật (engineering manager) còn trang khác nói tôi làm tự do chính là kiểu mâu thuẫn khiến mô hình trả lời nước đôi, hoặc chọn người khác.
Ngày sửa cũng phải thành thật. Nó đổi khi nội dung đổi, ngoài ra tôi không đụng vào. Đẩy ngày lên cho trông có vẻ mới là kiểu chiêu dùng được một lần, rồi cả tên miền của bạn bị hạ tín nhiệm.
llms.txt, và sự thật là chẳng ai đọc nó#
llms.txt là một đề xuất từ tháng Chín năm 2024 về một tệp Markdown đặt ở gốc trang, cung cấp cho mô hình ngôn ngữ một bản tóm tắt về trang cùng một danh sách liên kết chọn lọc. Tôi thêm một tệp như vậy vào tháng Hai năm nay. Nó gồm một đoạn về tôi là ai, rồi các mục cho quản lý, hạ tầng, di động và cộng đồng, mỗi bài một dòng: tiêu đề, URL, và một câu nói bài đó kết luận gì. Đọc nó giống như một mục lục viết cho người đang vội.
Điều đáng nói là chẳng ai đọc nó. Trong bốn ngày log tôi có, những request duy nhất tới /llms.txt là của chính tôi. Common Crawl đã lấy 76 trang của site này trong đợt thu thập tháng 8 năm 2026 mà chưa lần nào đụng đến tệp đó. Chưa có trợ lý lớn nào nói rằng họ đọc nó. Nên nó không phải lý do bất cứ thứ gì ở đây được trích dẫn, và tôi sẽ không khuyên ai làm nó vì lý do đó. Tôi giữ nó vì hai lý do. Nó tốn một tiếng, và việc viết cho mỗi bài một câu nói bài đó thực sự kết luận gì còn đáng giá hơn bản thân cái tệp, vì nó cho tôi thấy bài nào chẳng kết luận được gì. Nó cũng là trang duy nhất trên site nói cho máy biết trang này để làm gì, và tôi thà có mà không cần đến. Từ đó nó đã lệch đi, vì tôi viết tay và hay quên, và đó là lý do nên sinh nó từ front matter như một định dạng đầu ra (output format) của Hugo thay vì viết tay. Việc đó đang nằm trong danh sách.
Feed, sitemap và năm ngôn ngữ#
Phần đường ống nhàm chán vẫn có giá trị. Sitemap là cách trình thu thập dữ liệu tìm thấy bài mới ngay ngày nó lên. RSS là cách nó biết một bài đã thay đổi. Cả hai đều là mặc định của Hugo và tôi chưa bao giờ phải nghĩ đến. ClaudeBot đọc sitemap 36 lần trong hai ngày, và đó là cách nó tìm ra 1,380 trang nhanh đến vậy.
Ngôn ngữ là phần tôi không ngờ lại quan trọng. Mọi thứ ở đây có bản tiếng Anh, Nhật, Hàn, Trung giản thể và Việt, với các liên kết thay thế (alternate link) để trình thu thập dữ liệu biết chúng là cùng một bài. Các trình thu thập dữ liệu coi chúng như năm site riêng: lượt thu thập của ClaudeBot chia gần như đều cho cả năm, và trong 73 trang bài viết mà Common Crawl lấy hồi tháng 8, chỉ có bốn trang là bản tiếng Anh. Trợ lý trả lời bằng ngôn ngữ được hỏi và nghiêng về nguồn bằng chính ngôn ngữ đó, nên một câu hỏi tiếng Hàn về khởi động nguội trên Fly.io có thể được trả lời từ trang tiếng Hàn thay vì từ một bản dịch tại chỗ của trang tiếng Anh, và trang tiếng Nhật chính là trang mà ChatGPT thực sự đã tải về. Điều kiện là bản dịch phải đọc như thể được viết bằng chính ngôn ngữ đó. Lượt rà soát tôi làm đầu năm nay, có người bản ngữ kiểm tra, là dành cho người đọc, nhưng nó cũng là thứ khiến trang tiếng Việt trở thành một nguồn thay vì một món lạ.
Những gì tôi đo được#
Nhiều hơn tôi tưởng, một khi tôi thôi đoán mò. Gói miễn phí của Cloudflare cho xem log request theo user agent và đường dẫn, mỗi lần truy vấn được một ngày, và bảng bot ở trên là từ đó mà ra; còn muốn xem referrer thì phải lên gói trả phí. Google Analytics thì có referrer, và kéo chúng ra qua API thay vì căng mắt nhìn dashboard chính là cách tôi có được các con số ở đầu bài. Ghép hai nguồn lại thì thấy được hình dạng của câu chuyện. Trong bốn ngày, các bot truy xuất tải về khoảng chín mươi trang từ các địa chỉ của OpenAI và Anthropic. Trong tháng vừa rồi, có hai người đến từ ChatGPT. Đọc nhiều, thỉnh thoảng trích dẫn, hiếm khi bấm vào. Vẫn chưa có cách nào tôi biết để xem những câu trả lời đã dùng một trang mà không được bấm vào. Cách kiểm tra hữu ích nhất vẫn là làm bằng tay: hỏi trợ lý đúng câu hỏi mà bài của bạn trả lời, rồi xem nó trích trang của ai.
Nếu phải giữ lại một thứ từ tất cả những điều này thì đó là quy tắc viết. robots.txt, dữ liệu có cấu trúc và llms.txt là công việc của một buổi chiều, xong là xong. Viết sao cho mỗi phần nêu luận điểm trước, và viết về điều cụ thể thay vì điều chung chung, là một thói quen, và chính thói quen đó quyết định một trang có đáng trích dẫn hay không. Điều thứ hai là hãy đo trước rồi hãy khẳng định. Hóa ra được máy tin cậy trông rất giống được người tin cậy: nói bạn là ai, nói bạn biết gì, và lần nào cũng nói theo cùng một cách.