声明。 这次迁移和这篇文章是 Codemagic 付费委托的。他们只对事实准确性做了一轮审阅,不涉及语气,文中没有任何内容是应他们要求修改的。凡是我遇到问题并反馈了的地方,我都会说明;如果你读到这里时问题已经修复,文中会写成已修复。
2026 年 9 月 23 日更新。 我反馈的问题,Codemagic 的开发者都逐一处理了。大部分已经修复,包括 iOS 版本检测的 bug、重复计数的安装、首次运行时的静默,以及那条吵闹的调试命令;文档现在也写到了已提交的原生工程和崩溃回滚的额度。下文中每个问题出现的地方我都标注了,仍未解决的那几个保持原样。
二月我写过一篇自己搭 Expo 更新服务器的文章,用的是 Django 和 Tigris。它现在还在跑。我运营的社区应用 maru 从那以后每一次 OTA 修复都走它,两个平台都是,每月大约一美元。
这也意味着每一块都归我管:两个 Django 模型加一次迁移、一个 430 行的 viewset、一条 400 行的管理命令、一个 210 行的发布脚本、一个导入密钥,还有一堆坑,每个坑都是靠一次坏掉的更新学来的。坐下来做规划时我才发现,那个脚本从我写它的第一天起,每次生产发布之后都会打印 “Sent 0 push notifications”,读的是一个这台服务器从未返回过的字段。没人注意到,最没注意到的就是我。自己维护一套东西,大概就会变成这样。
所以当 Codemagic 问我要不要试试 Patch,他们那套开源、可自托管的 CodePush 替代品,我答应了,只有一个条件:要用真实的应用,而不是 demo。真实的签名、真实的发布流程、已经提交进仓库并且手改过的原生工程,全套。大多数打算离开 EAS Update 的人,要迁的都是这样的应用,不是刚生成的模板。
下面就是整个过程,毛边都留着。
Patch 是什么#
Patch 是一台你自己跑的服务器,加一个放进应用里的 SDK。服务端包括一个 API、一个后台 worker、Postgres、S3 兼容的对象存储和一个 Web 面板,打包成一套 Docker Compose 栈。客户端是 @codemagic/react-native-patch,一个支持 iOS 和 Android 的 TurboModule,附带 Expo 配置插件,再加一个 CLI,cmpatch,负责打包 JavaScript 并发布。
读完源码之后,有两个设计决定让我印象深刻。
第一,应用从不向 API 询问有没有更新。发布一个 release 时,worker 会把纯 JSON 的清单写进对象存储,应用只是去取那些文件。一次更新检查就是对存储或 CDN 的两个静态 GET,API 只接收指标。我的 Django 接口原来站在每一次应用启动的请求路径上;这一套想站也站不上去。
第二,每个 release 都精确地写明它面向哪个二进制版本,CLI 会对你的原生工程算一个指纹,拒绝把 JavaScript 发到原生代码对不上的二进制上。我的服务器有一个 runtime_version 字段,剩下的全靠祈祷。
先在自己笔记本上试#
文档一上来让你搭的是本地评估栈,从这里开始是对的。
npm install -g @codemagic/patch-cli
cmpatch selfhost local-eval up
CLI 两秒就装好了。整套栈第一次起来花了 3 分 14 秒,大部分时间在本地构建服务器和面板的镜像,而且在非交互模式下,这期间它什么都不打印,看起来和挂死一模一样。(现已修复:它现在每一步会打印一行进度。)然后四个健康的容器就出现了,全部绑定在 localhost:面板在 8080,API 在 3000,Postgres,还有 MinIO 在 9100。它很懂事地避开了我自己那套栈已经占用的端口。
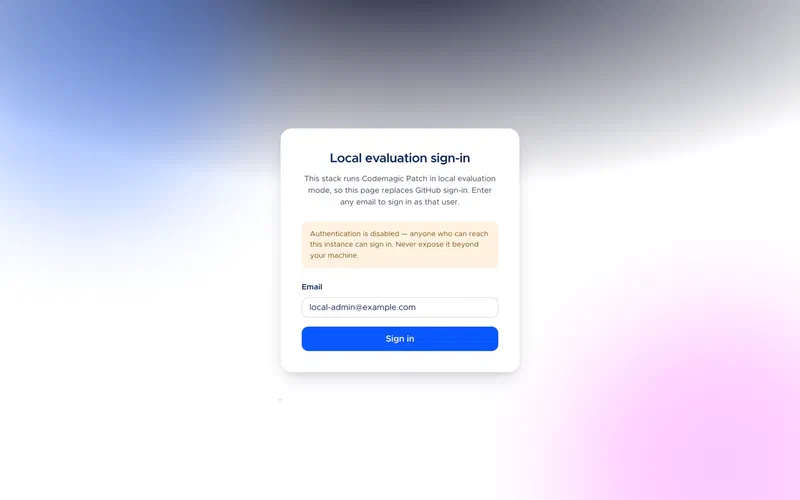
这个模式下登录是关掉的,每个页面上都有一条警告,叫你别把它暴露出去。
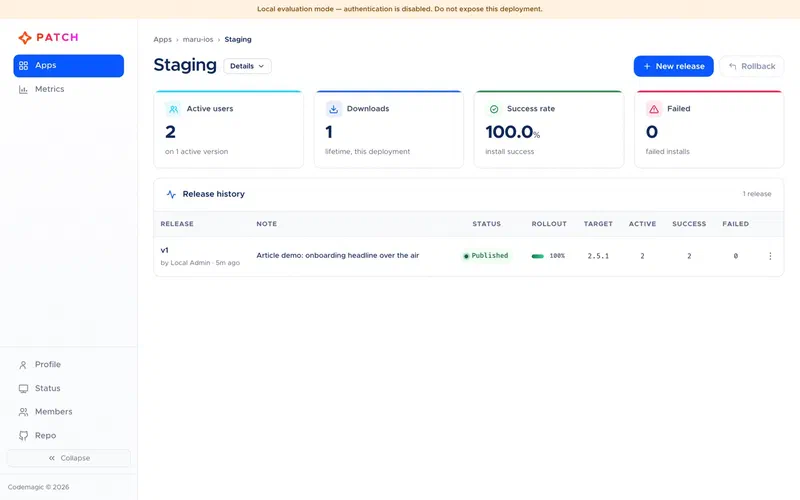
栈自带一个叫 Example Data 的种子应用,在你发布任何东西之前值得先看一眼,因为它展示了面板是用来干什么的。接下来两张截图里的数字都是种子数据,不是真实用户。
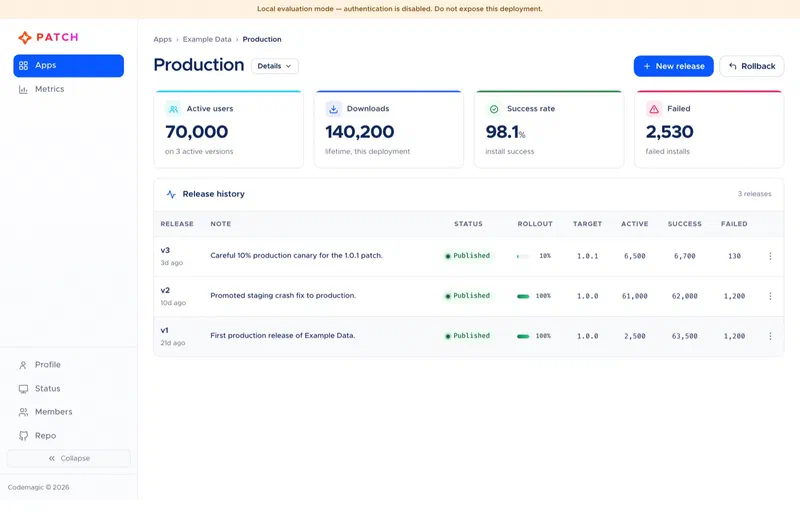
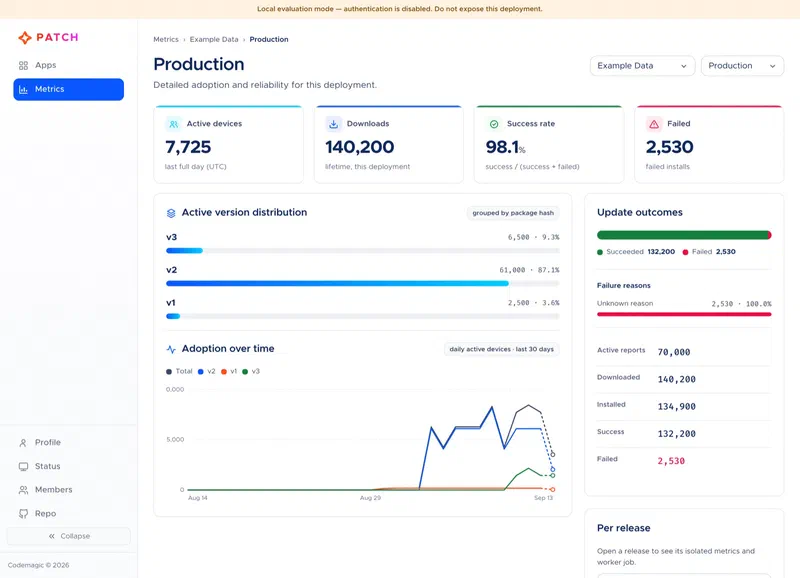
作为对比,我的面板是 Django admin 里的更新记录列表,带一个 “is active” 复选框。到底有多少台手机真的装了更新,我完全不知道。
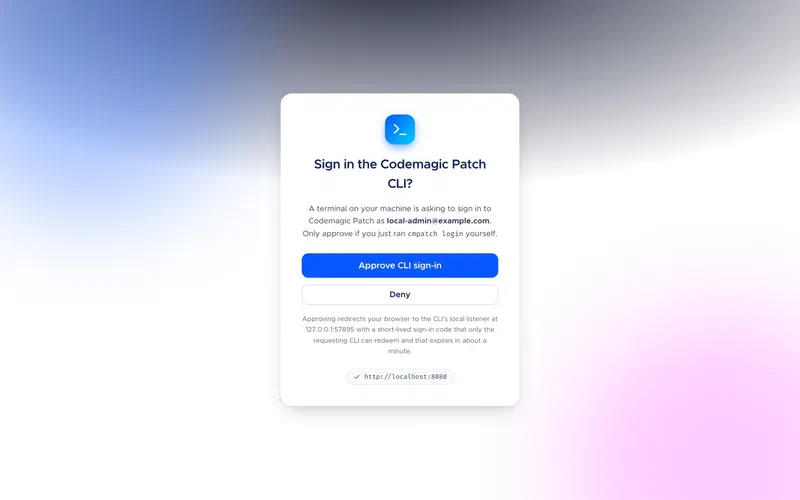
CLI 登录是一套正经的浏览器流程,带 PKCE 和 localhost 回调,批准页面会告诉你是哪个账号在请求,以及授权码大约一分钟后过期。
对准一个真实应用#
Patch 要求每个平台一个应用,每个应用会自动建好 Staging 和 Production 两个 deployment。我在面板里建了 maru-ios,又用 cmpatch app create 建了 maru-android,主要是两种方式都看看。建完应用后弹出的对话框是整个产品里对迁移最有用的一屏:两个 deployment key、SDK 需要的两个 URL,还有一句说明:deployment key 不是机密。
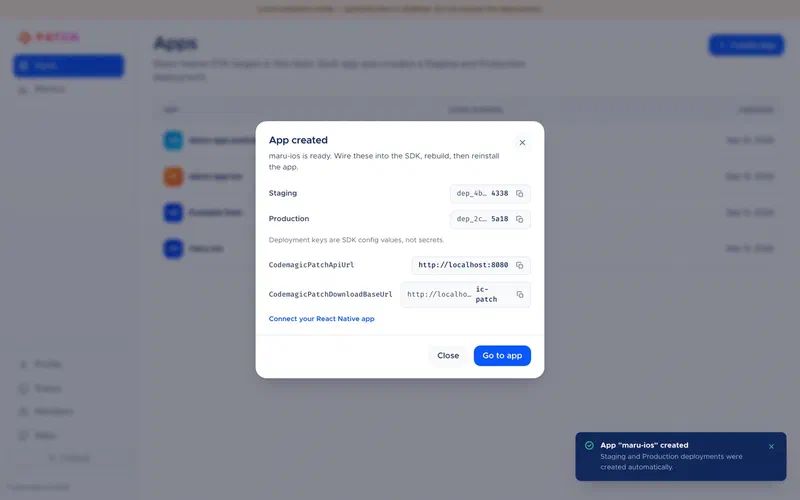
两件小事。cmpatch init 当时是把项目关联到已经存在的应用上,所以不管迁移指南怎么暗示,它都不可能是第一条命令。这一点后来修好了:在交互模式下,它现在会自己给每个平台建一个应用。另外,对话框给的 API URL 是 http://localhost:8080,而文档和 CLI 说的是 3000。两个都能用,因为两个端口都同时提供这两种服务,但你会犯嘀咕。
接着我对着还没动过的应用跑了 cmpatch doctor,三秒钟它就找出了一个真问题。它报告 iOS 二进制版本是 2.0.0。应用其实是 2.5.1。
CLI 会找出 ios/ 下所有的 Info.plist,如果没有一个路径里带 “test”,就按字母顺序取第一个。maru 有一个 WidgetKit 扩展,ios/ExpoWidgetsTarget/Info.plist 排在 ios/maru/Info.plist 前面。我这个扩展的 plist 还停在 2.0.0,这是我的 bug,但后果很难看:自动检测会把每一个 iOS release 都对准一个没有任何手机在跑的版本,而且不会报任何错。更新只是永远不会到,正是我在 Tigris 那篇里警告过的那种故障。Android 读 versionName 是对的。绕过的办法是传 --target-binary-version 或 --plist-file,我的发布脚本现在会先检查 app.config.js 和两个原生工程的版本一致,然后显式传入版本。后来同一个 bug 又让 doctor 自己的清单检查在一个运行正常的 deployment 上失败,因为它跑去找 2.0.0 版本的清单了。修好过期的 plist 之后,doctor 的 24 项检查全部通过。
Codemagic 后来修复了这个问题。CLI 现在读取的是应用 target 的 Info.plist,而不是扩展的;如果有不止一个 target 可能是应用,cmpatch 会问你是哪一个。
JavaScript 这一侧#
去掉 expo-updates、加上 SDK,是两行的改动。把应用原来围绕更新做的那些事换过来,要多想一想。
maru 在启动时和每次回到前台时检查更新,最多每十五分钟一次。发现更新就下载,然后提议重启;你说不,它就在下一次冷启动时应用。设置页里还有一个手动检查,显示当前跑的是哪个 bundle,错误上报器也会给每份报告打上它来自哪个更新的标签。
从 SDK 源码里学到的第一件事是,它在 import 时就用 TurboModuleRegistry.getEnforcing 查找原生模块,模块不存在就直接抛错。maru 还有一个 Web 构建,顶层 import 会把 Web 应用整个搞挂。所以一切都走一个懒加载 SDK 的小模块,配一个什么都不返回的 .web.ts 孪生文件,这样还能把 SDK 彻底挡在 Web bundle 之外。
// services/ota.ts
export function patchSdk(): PatchSdk | null {
  if (sdk !== undefined) return sdk;
  if (Platform.OS === "web") return (sdk = null);
  try {
    sdk = require("@codemagic/react-native-patch") as PatchSdk;
  } catch {
    sdk = null;
  }
  return sdk;
}
自动检查本身主要就是 sync(),它从不抛错,而是 resolve 成一个状态:
const status = await patch.sync({
  installMode: "ON_NEXT_RESTART",
  mandatoryInstallMode: "ON_NEXT_RESUME",
});
if (status === "update-installed") offerRestart();
SDK 对强制 release 的默认值是 IMMEDIATE,不管用户正在干什么都会直接重载 JavaScript。我改成了下次从后台回来时再应用,因为弄丢一篇写了一半的帖子,这个 bug 比大多数修复带来的好处都要糟。当时 InstallMode 是字符串联合类型,不是文档示例里暗示的那种枚举对象;现在它导出为一个常量对象,所以 InstallMode.ON_NEXT_RESTART 可以照文档那样用了。
原生这一侧,当 ios/ 和 android/ 已经提交进仓库#
迁移指南说,加完配置插件后跑 npx expo prebuild --clean。我在另一个 checkout 里跑了,它删掉了六张教程图片、我的 Android 网络安全配置、iOS 隐私清单和 Podfile.lock,还把 build.gradle 里一个 Detox 修复连同 Info.plist 里的几百行一起回退了。不加 --clean,Expo 照样把两个目录清空。
这不怪 Patch。maru 一开始是托管的 Expo 应用,后来长出了原生定制,所以 ios/ 和 android/ 是提交进仓库的,EAS 拿它们原样构建。但长这样的应用多得很,指南当时没有提醒。现在有了:Expo 迁移指南分成两条路径,生成原生工程的走 prebuild,已提交原生工程的则列出需要手动应用的具体改动。
插件实际改的东西,其实少到可以手动完成。iOS 上,AppDelegate.swift 里一个 import 加一行:
return CodemagicPatch.bundleURL() ?? Bundle.main.url(forResource: "main", withExtension: "jsbundle")Android 上,MainApplication.kt 里一个 import 加一个参数(这是 React Native 0.82+ 的写法;更早的版本是改写 getJSBundleFile()):
ExpoReactHostFactory.getDefaultReactHost(
  jsBundleFilePath = CodemagicPatch.getJSBundleFile(applicationContext),
  // ...
再加上每个平台三个配置值,以及删掉旧的 expo-updates 设置:两个工程加起来新增 13 行、删除 20 行。
插件会在 prebuild 时把那些配置值写成字面量,对于提交了原生工程的项目,这意味着每次构建都只能有一个写死的 deployment。我想让 preview 构建走 Staging、商店构建走 Production,用的还是同一个工程,所以这些值改成从构建环境来。Info.plist 里,Xcode 会展开构建设置:
<key>CodemagicPatchDeploymentKey</key>
<string>$(PATCH_IOS_DEPLOYMENT_KEY)</string>
android/app/build.gradle 里:
def patchEnv = { name -> System.getenv(name) ?: (findProperty(name) ?: "") }
resValue "string", "CodemagicPatchDeploymentKey", patchEnv("PATCH_ANDROID_DEPLOYMENT_KEY")
这些 key 于是和 EXPO_PUBLIC_ 那些值一起放在 eas.json 的各个构建 profile 里。值为空时 SDK 会安静地什么都不做,本地构建没关系,商店构建就是灾难,所以 app.config.js 现在会在 preview 或 production 的 EAS 构建缺了这些值、或者还指向 localhost 时直接抛错。
第一次更新#
第一个 release 我改的是引导页的大标题,不用登录就能看到,然后发布:
./scripts/publish-patch-update.sh ios --local --notes "Onboarding headline over the air"耗时 30 秒,大部分是 Metro 和 Hermes。上传完成 0.6 秒后,服务器的 worker 就发布了清单。这个更新是一个 7.3 MB 的压缩 tarball,而我旧的导出流程产出的是 11 MB 的 Hermes bundle 加资源。
这里有一件事要做对:JavaScript bundle 在构建时会把 EXPO_PUBLIC_ 那些值内联进去,所以一次更新必须用和它要落上去的那个二进制相同的值来构建,否则你发出去的 JavaScript 会连到错误的后端。我的脚本从构建那个二进制的同一个 eas.json profile 里加载它们。Patch 的 CI 文档现在也把这一点写清楚了,还说明了 release-react 本身不会读取 EAS profile。
然后我重新启动应用。设备日志显示整个更新检查就是对对象存储的两次请求,meta.json 和 2.5.1/manifest.json。启动三秒后 SDK 写下了一条 Downloaded 事件,把更新暂存好,应用弹出了重启提示。
bug 是我的#
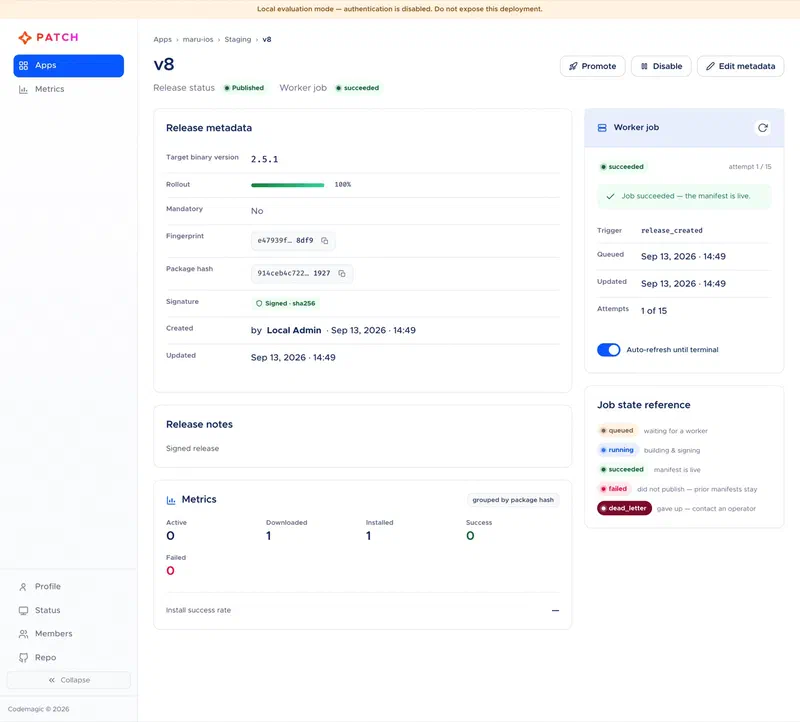
然后我看了看面板。一台模拟器装了 release v1,面板却显示两次成功安装、两个活跃用户。
SDK 把自己的状态和待发送的指标事件以文件形式存在应用容器里,追起来很方便。里面有两条 Success 事件,时间戳完全相同,id 不同。我的 hook 在挂载时用 notifyAppReady() 确认当前 bundle,紧接着就调用 sync(),而 sync() 自己也会调用 notifyAppReady()。两次调用重叠了,各自都看到这个 release 处于待确认状态,各自都记了事件。服务器按事件 id 去重,但这两条 id 不同,所以都算数了,而且这些重复是永久的。
我这边的修复是每次启动只做一次共享的确认,其他所有东西都等它。SDK 自己也可以防一下重叠调用,这一点我提了建议。现在它确实这么做了:重叠的 notifyAppReady() 调用,包括 sync() 内部那一次,会共用同一次确认,所以每次安装只记一次。SDK 参考文档现在也写明了 sync() 会自己确认就绪,用它的应用不需要再单独调用 notifyAppReady()。
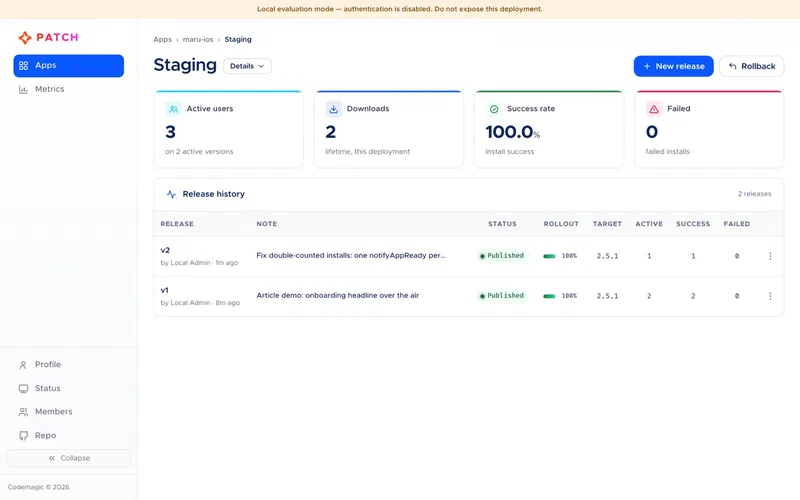
舒服的地方在于发修复。这是纯 JavaScript 的改动,所以作为 release v2 发了出去,而且因为可以给 v1 上的设备发二进制差分,v2 下载下来是一个 543 KB 的 patch,而不是 7.3 MB 的 bundle,大约是原来的 7%。重启之后:一次下载、一次安装、一次成功、一台活跃设备。
故意弄坏它#
回滚是我最在意的功能,因为旧方案在设备端什么都没有。一个坏更新会让每次启动都崩溃,直到我注意到并把复选框取消勾选。
所以我发了一个 v3,在第一次渲染之前就抛错,也就是它永远没机会调用 notifyAppReady()。应用下载了它,提示重启,然后死回了主屏幕。
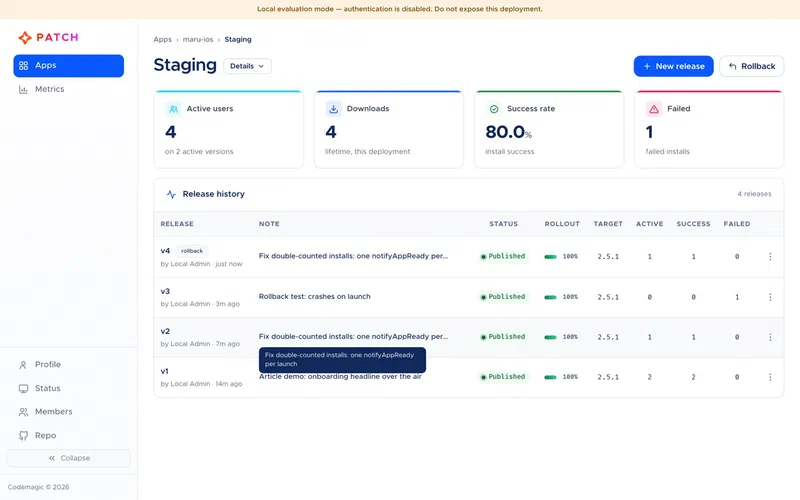
下一次启动又跑了 v3,又崩了,这让我很意外,因为文档说在 notifyAppReady() 之前崩溃的 bundle 会被回滚。源码解释了原因:SDK 允许三次未确认的启动,之后才判定为崩溃,因为一次未确认的启动也可能只是 iOS 在任何 JavaScript 跑起来之前就杀掉了一个健康的进程。第四次启动回到了 v2。
然后设备自己上报了这次失败,类型是 crash_rollback,面板把它记在了 v3 名下。这个设计合理,但有必要把它的含义说白:一个坏 release 会让每个用户崩三次启动才能恢复,而当时文档没有提这个数字。现在提了,而且这个额度可以配置,原生侧用 CodemagicPatchMaxLaunchAttempts,或者用 Expo 插件的 maxLaunchAttempts。这正是先发 Staging、再小比例发 Production 的理由。
替其他所有人叫停一个坏 release 是一条命令,不到一秒:
cmpatch release rollback --app maru-ios --deployment Staging它不改写历史。它把上一个 release 重新发布成一个新的(v4,标记为 v2 的回滚),所以崩溃的那个 release 连同它的失败计数一起留在列表里,这是诚实的记录。面板上通过一个对话框做同样的事。
Android#
Android 有两个意外,都不是 Patch 的问题。我给 SDK 加的 R8 keep 规则放在 app.config.js 里,而它只能通过 prebuild 才能到达原生工程,所以我第一个 release 构建等于无意中测试了 SDK 在没有 keep 规则的情况下能不能扛住 R8。能:R8 把它所有的类都重命名了,更新照样下载、安装、回滚,一切正常。另外,刚冷启动的模拟器加上还占着内存的 Gradle,慢到我的第一次测试在 SDK 完成那个早已开始的下载之前 45 秒就放弃了。
Release v1 应用成功,一次成功、一台活跃设备,一个会崩的 v2 在同样的三次启动额度之后回滚了。
顺利路径之外#
更新能到、能回滚是核心,但一个团队天天用的是其他那些功能,所以我一个一个过了一遍。
灰度发布是确定性的,这点我喜欢。md5(deviceId + "-" + releaseLabel) 的前八位十六进制数字对 100 取模,小于灰度百分比的设备就在圈内,所以同一台手机对某个 release 要么一直在、要么一直不在。我算出模拟器在下一个 release 里落在 91 号桶,按 25% 发布,模拟器果然什么都没收到。用 cmpatch release patch 提到 95%,不到一秒,下次启动它就更新了。
接着我的下一个 release 失败了,返回 409:“deployment has an active rollout below 100 percent”。每个 deployment 同时只允许一个部分灰度,所以你得先把金丝雀发完、禁用或者回滚,才能发别的。这合理,也有文档,但一条每次合并都发布的流水线会在金丝雀进行到一半时撞上它。我反馈之后,CLI 在这里会把话说清楚了:如果是一个进行中的部分灰度挡住了你,它会告诉你等也没用,以及怎么把灰度发完或禁用;如果是另一个发布任务还在跑,它会让你用 release inspect --wait 等着。文档现在也有一节专门讲按顺序进行的发布变更。
强制 release 用的是 SDK 的 mandatoryInstallMode。我设的是下次回到前台时应用,应用下载了更新并弹出提示,我无视提示,把应用切到后台再切回来,新版本就直接在那里了。
禁用一个 release 做的不只是停止提供它。我一禁用最新的那个,清单就立刻指向了仍然启用的最新 release,禁用版本上的设备会被推一个回到它的 patch。把某个二进制版本的 release 全部禁用,清单的目标就变成 null,SDK 会把应用退回到它随二进制自带的 bundle。我的更新 hook 起初没有对这种情况弹提示,现在有了。
从 Staging 提升到 Production 不到一秒,而且复用的正是测试过的那个包,同样的哈希和备注,不会重新构建。它还接受一个灰度百分比,所以“提升到 Production 的 10%”就是一条命令。
构建和发布也可以拆成两步。cmpatch bundle 产出一个 .cmpatch 产物,面板的 “Bundle upload” 选项会在上传前读取它:平台、目标版本、指纹、签名状态、大小和打包器。这适合 CI 构建产物、再由别人决定什么时候发布的场景。
也是在这里,我真正撞上了指纹保护。修好过期的 widget plist 之后,服务器以 409 拒绝了我的下一个 release,因为原生工程的指纹和它为 2.5.1 记录的那个对不上了。Android 上,改一下 app.config.js 里的注释就够触发了,因为 Expo 把应用配置也算进指纹。面板把同样的检查显示成一条警告,带两个指纹和一个 “Upload anyway” 按钮。这两次已安装的二进制上都没有任何原生的东西变过,所以覆盖是对的。但在真实使用里,诚实的答案几乎总是升版本号、重新做一次商店构建,我的发布脚本现在遇到这种情况就会这么说。
代码签名用的是 RS256:CLI 用 RSA 私钥给包的哈希签名,SDK 用编译进二进制的公钥校验。公钥以一行 base64 的形式放进去,正好契合我走构建设置的做法,两个平台我都测了。应用里带了公钥之后,未签名的 release 在下载前就被拒了。给应用打开 “require code signing” 后,服务器拒绝了未签名的发布,错误信息里写明了修法并链接到指南。签名的 release 正常安装,SDK 记录签名为已验证。当我禁用签名的那个 release、服务器退回到一个更早的未签名 release 时,SDK 也把它拒了。要注意的是,公钥必须在你发出的第一个二进制里就带上,因为更新没法把它加进去。
团队和 CI 也都覆盖到了。成员会拿到四种团队级角色之一(owner、admin、developer、viewer),邀请会一直等到对方第一次登录。个人访问 token 在空的 home 目录下也能用,通过 --token 或环境变量传入都行,token 列表会显示每一个上次使用的时间。我还写了一个手动触发的 GitHub Actions workflow,在 Linux runner 上跑同一个发布脚本,签名密钥来自 secret,不过还没跑过,因为它需要托管的服务器。
有一个工具当时我会跳过,cmpatch debug ios。它按 “OTA” 不区分大小写过滤系统日志流,而这会匹配到 “Rotation”,于是一次二十秒的应用启动产出了满屏的 SpringBoard 消息,应用自己的一条都没有。这已经修好了:它现在只显示带 SDK 标记的行。SDK 本身日志不多,主要是错误和开发构建下的警告,所以输出会很安静。你可能看到的那条 getpwuid_r 警告来自 xcrun simctl,不是 Patch。
到底有多难#
Codemagic 想听我的看法,那就尽量说得直白。
试用很容易。两条命令、几分钟,你就有了真正的服务器、一个带演示数据的面板,和一个可以对准自己应用的 CLI。我会说这是头一个小时里最好的部分。
集成 SDK 是中等工作量,而且难点大多在你自己的项目里,不在 Patch。在一个原生目录是生成出来的新 Expo 应用上,确实就是插件加几行替换 expo-updates 调用的代码。在 maru 这样的应用上,原生工程已提交、有 widget 扩展、有 Web 构建、有 R8 和构建 profile,活儿都在边边角角。我得手动应用原生改动来避开 prebuild,把配置改成构建时注入好让 Staging 和 Production 构建能不一样,还要把 SDK 挡在 Web 之外。我还得保证更新里的 JavaScript 和二进制用同样的环境构建。搞明白之后没有一件是难的。我做的时候,这些大多不在文档里,不过已提交原生工程的路径和 bundle 构建时的环境,现在都写进去了。
日常使用很好。发布是一条命令,半分钟左右。灰度、提升、禁用和回滚,从 CLI 或面板操作都不到一秒,错误信息会说出了什么问题、该怎么办。服务器的那些保护(指纹检查、同时只能一个金丝雀、签名)严格得不止一次拦住我做错事。
在生产环境跑它是更大的承诺。它是一套带 Postgres 和对象存储的 Docker Compose 栈,你得托管、备份、升级,还需要两个域名和一个 OAuth 应用。对已经在跑服务器的团队,这是一个安静的下午。对那些正因为不想碰服务器才用 EAS 的团队,这才是切换的真实成本,比 SDK 那部分工作更大。
按挂钟时间算,我 12:29 装好 CLI,13:34 第一个更新在模拟器上应用成功,其中半小时是一次 Xcode 构建卡住了,原因和 Patch 无关。这篇文章里的所有东西,两个平台,都在下午过半之前做完了,托管服务器不算在内。
最耗我时间的几件事,按顺序:expo prebuild --clean 抹掉了我提交的原生工程,然后是研究怎么手动接好一切;iOS 版本检测的 bug,它会把更新发给一个没人在跑的版本;重复计数的安装,虽然是我自己造成的,但任何人都很容易重蹈,因为 sync() 自己会调 notifyAppReady();还有没写进文档的三次启动崩溃额度,在一次测试进行到一半时把我吓了一跳。再往后是一些本身正确、但需要规划的事:无害的原生相关改动触发指纹保护,每个 deployment 同时只能一个金丝雀,以及不能重叠的生命周期任务,一旦脚本要连着做几件事,这就很要紧。剩下的都是小事:首次运行时静默的搭建过程、一条吵闹的调试命令,还有几个当时和代码对不上的文档示例。
这些我都连同细节一起写给了 Codemagic,到 9 月 23 日,大部分已经修复:版本检测、重叠的确认、prebuild 的提醒、崩溃额度、静默的搭建过程、调试命令、InstallMode 的示例,以及发布任务或金丝雀挡路时给出的报错。还没解决的都是小事:面板显示 API 在 :8080,而其他地方都说 :3000;SDK 在 Web 和 Jest 里一 import 就抛错;以及文档里的几处空白。
上生产#
上面的一切都是在评估栈上跑的。生产就是同一个应用、同一套脚本对准一台真实的服务器,下面是 maru 的计划。
官方支持的服务器部署方式是 Docker Compose 安装:一台开放 80 和 443 端口的 Linux 机器、两个域名(一个给 API 和面板,一个给下载),以及一个用于登录的 GitHub OAuth 应用,没有它服务器不会启动。安装器负责剩下的事,包括 TLS:
scripts/selfhost/install.sh \
  --api-domain updates.example.com \
  --storage-domain storage.updates.example.com \
  --email [email protected] \
  --github-oauth-client-id <id> --github-oauth-client-secret <secret>
它会写一个 .env.selfhost,里面是数据库和存储的密钥,应该放进你的密码管理器。
不过你不一定要用自带的数据库和存储,这正是它能嵌进我这种栈的原因。maru 的 API 已经跑在 Fly.io 上,文件放在 Tigris,Patch 在两者上都能工作。Compose 文件底下,服务器就是一个以 MODE=all(API 和 release worker 一起)运行的容器,需要一个 Postgres 数据库、S3 兼容存储,和一个供文件访问的公开 HTTPS URL。也就是一个用仓库的 Dockerfile 构建的 Fly 应用(目前还没有发布的镜像,所以由 fly deploy 来构建)、一个 Fly Postgres 数据库,和一个 Tigris 桶:
MODE=all
DATABASE_URL=postgresql://…            # Fly Postgres
STORAGE_ADAPTER=s3
S3_ENDPOINT=https://fly.storage.tigris.dev
S3_REGION=auto
S3_BUCKET=maru-patch
S3_FORCE_PATH_STYLE=true
PUBLIC_BASE_URL=https://maru-patch.fly.storage.tigris.dev/codemagic-patch
两点提醒。在 Compose 之外运行,仓库里的文档把它定位为参考材料,而不是这个首个开源版本里受支持的路径,所以在 Fly 上,升级和备份得靠你自己。我也还没这样部署过;这是计划,不是报告。另外,如果你读过我写 Fly 缩容到零的那篇,记得至少留一台机器在跑。手机做更新检查时从不等 API,因为清单直接来自存储,但不然的话,每一次指标上传和每一个 release 任务都会从一次冷启动开始。
Tigris 是我最期待的部分。maru 的文件本来就在那儿,而且它在每次应用启动都要访问的那个 URL 前面放了一层 CDN。这么做的话要留意清单的缓存:用普通的 base-URL 分发适配器时,Patch 会把清单以 no-cache 提供,因为它没法清 CDN,而一份按自己 TTL 缓存的清单会一直提供你刚刚回滚掉的那个 release。配置参考现在在 MANIFEST_CACHE_CONTROL 下写明了这一点,文档站也讲到了 S3 兼容存储。
在托管服务器上,重新建一遍应用,把新的 key 放进 eas.json 的 preview 和 production profile(分别是 Staging 的 key 和 Production 的 key),再创建一个用于发布的 token:
cmpatch token create --name ci想要代码签名的话,现在就定:生成生产环境的密钥对,私钥作为 CI secret 保管,公钥放进构建 profile,然后给两个应用都打开 “require code signing”。第一个 Patch 二进制还需要一个新版本号,因为商店里已有的二进制跑的是 expo-updates。先用 preview profile 构建给 TestFlight 和 Play 内部测试,交给任何人之前,先确认 key 真的进了构建出来的 Info.plist 和 Android 资源。这是我本地测试唯一没有覆盖到的一环,因为环境变量是我手动导出的。然后发到 Staging,确认每个测试者一次下载、一次成功,之后才构建商店版本。
生产 release 从小开始,逐步放大:
npm run publish-update:prod -- --rollout 10
cmpatch release patch --app maru-ios --deployment Production --label v1 --rollout-percentage 100
旧的 Django 服务器这期间继续开着。所有还没更新的 2.5.1 副本仍然在向它检查,给它们的热修复也仍然走旧脚本。等日志显示那些请求停了,模型、viewset、命令、脚本和密钥就可以全部删掉。
想对正在付 Expo 账单的人说的话#
如果你付费用 EAS Update 是因为搭服务器看起来太费事,Patch 是一个实在的答案:你确实要跑一台服务器,但那是一套 Compose 栈和一个安装器,不是你要维护的代码。和我自己搭的那套相比,你会得到灰度发布、每个 release 的安装和失败数字、二进制 patch、指纹保护、代码签名、设备端的崩溃回滚,和一个回滚按钮。这些我一个都没做过。
代价是:在任何人收到 Patch 更新之前先要发一个新二进制,因为 SDK 得进到应用里;一台要持续升级和备份的服务器;release 坏得够彻底时每个用户三次崩溃启动(默认值);以及原生工程已提交的话,一些手工活。它也还年轻。这是 0.3.0 版本,我碰到了一个版本检测 bug、一条吵闹的调试命令和文档里的几处空白,还自己造了一个 SDK 本可以防住的 bug。版本检测和调试命令后来都修好了,文档的空白大多补上了,SDK 现在也能防住我犯的那个错。这些都没有挡住迁移,而且全都看得见,在 CLI 里、在面板里、或者在设备上 SDK 自己的文件里,这一点我的旧方案可说不上。