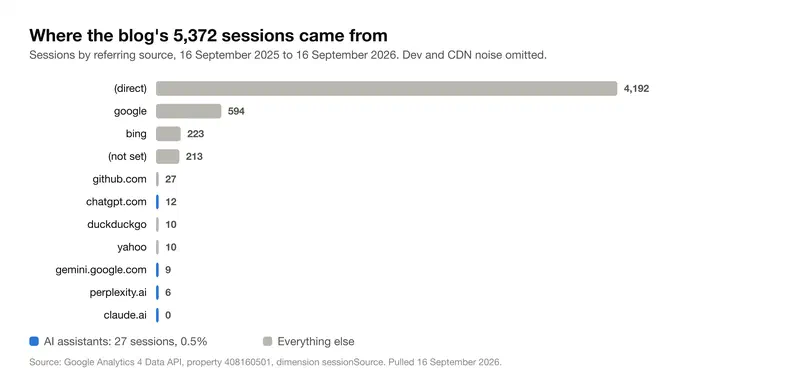
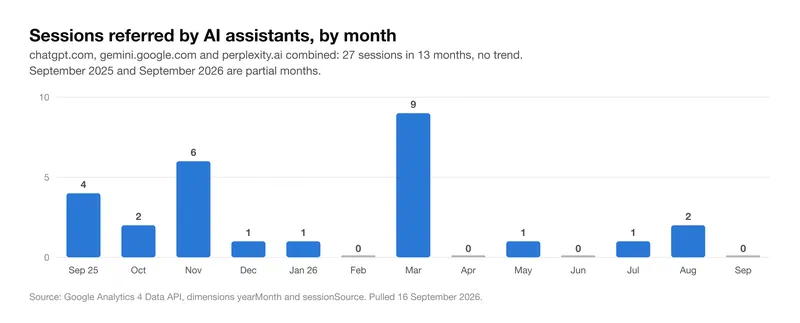
这个博客的搜索流量已经平了两三年,我也不指望它再动了。所以我转而去看访客都是从哪来的,AI 助手在不在其中。在,勉强算在。截至 2026 年 9 月 16 日的十二个月里,Analytics 记到这里有 5,372 个会话。其中 27 个来自 AI 助手:12 个来自 chatgpt.com,9 个来自 gemini.google.com,6 个来自 Perplexity,来自 claude.ai 的是零。半个百分点。不过从 ChatGPT 来的访客是好的那种。他们平均停留五分钟,直接访问是 27 秒,Google 来的是三分钟,因为他们已经读过答案,想看的是细节。
所以我花了些时间琢磨,一个小博客怎么才能被选中当这些回答的来源。这篇写的是我在这个站上做了什么,以及日志对此怎么说。有数字的地方我给数字,靠猜的地方我说明是猜。初稿里有三句话,一查之下发现是错的,我把改正留在了文里。
两种 bot,只有一种会引用你#
第一件要弄清楚的事:“AI bot” 其实是两种不同的活,用的是不同的 user agent,拦住一种对另一种毫无影响。
训练爬虫成批地抓页面,用来训练下一个模型。OpenAI 的叫 GPTBot,Anthropic 的叫 ClaudeBot,Google 的由 Google-Extended 这个 token 控制,Apple 的是 Applebot-Extended,Common Crawl 的 CCBot 则喂着大多数开放数据集。它们拿走的东西最后变成权重,不会有任何链接指回你。拦掉这些是有道理的,我不觉得这想法傻。
检索 bot 是另一种。有人问 ChatGPT、Claude 或 Perplexity 一个问题时,助手会跑一次搜索,当场抓几个页面,读一遍,然后写出带引用的回答。这些抓取来自 OAI-SearchBot 和 ChatGPT-User、Claude-SearchBot 和 Claude-User、PerplexityBot 和 Perplexity-User。Google 的 AI Overviews 用的就是普通的 Googlebot,所以根本没有单独的开关。会把访客送回来的是这些 bot。如果目标是被引用,你要优化的就是它们,而且值得知道的是,拦不拦 GPTBot,ChatGPT 的搜索结果都不会因此变好或变坏。
这个站的 robots.txt 是 Hugo 的默认,也就是全部放行:
User-agent: *
Allow: /
Sitemap: https://jared.lynskey.co.nz/sitemap.xml
我想过把它拆开,放检索 bot 进来,把训练爬虫挡在外面,最后觉得对一个存在意义就是被人读的博客来说不值得。真要那么做的话,写出来就是下面这样。把它放出来是因为和Cloudflare 给 Googlebot 发了一个空页面里的教训一样:列表里写的得是 bot 的名字,不是厂商。没有哪一行能写成"OpenAI"。
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: CCBot
Disallow: /

User-agent: *
Allow: /
站在 Cloudflare 后面的话,有一件事要查一下。从 2025 年年中起,那里新建的 zone 默认拦 AI 爬虫,bot 设置里还有一个一键开关,能对已有的 zone 做同样的事。它两种都拦。这个博客上周刚搬到 Cloudflare Pages,所以这件事在我的清单上。如果你因为"AI bot"听起来像该挡的东西就把它打开了,那你也把引用一起关掉了。Cloudflare 后来开始在它托管的 robots.txt 里写一行 Content-Signal,带 search、ai-input 和 ai-train 三个独立的标志。没人有义务遵守它,但这套词是对的:和上面一样的划分,只是表达成一种偏好,而不是一堵墙。
真正来敲门的是谁#
搬到 Cloudflare 有个副作用:我头一次能按 user agent 看到每一个请求。下面是 2026 年 9 月 13 日到 16 日这四天进来的东西,假冒的已经剔掉了,那部分后面再说。
| Bot | 请求数 | 做了什么 |
|---|---|---|
| ClaudeBot(训练) | 1,777 | 两天里抓了 1,380 个不同页面,五种语言全在内,另外读了 37 次 robots.txt |
| meta-externalagent(训练) | 1,748 | 一样,晚一天 |
| OAI-SearchBot(ChatGPT 的搜索索引) | 59 | 五种语言的页面都有,robots.txt 读了十六次 |
| ChatGPT-User(回答时抓取) | 20 | Fly.io 冷启动那篇的日语版、Expo 更新服务器那篇、首页 |
| Claude-User(回答时抓取) | 8 | 更新服务器那篇、联系页、首页 |
| PerplexityBot | 2 | iOS 调试那篇,英语版和越南语版 |
| Claude-SearchBot、Perplexity-User | 0 | |
| Googlebot / Bingbot / Applebot / CCBot | 168 / 71 / 45 / 28 |
有两点很显眼。训练爬虫把整个站读了两遍,用的时间只够检索 bot 读几十个页面。而检索 bot 抓的不是随机页面:ChatGPT-User 和 Claude-User 都奔着更新服务器那篇去了,那是站上最具体的一篇,日语的冷启动那篇被抓的也正是日语版。
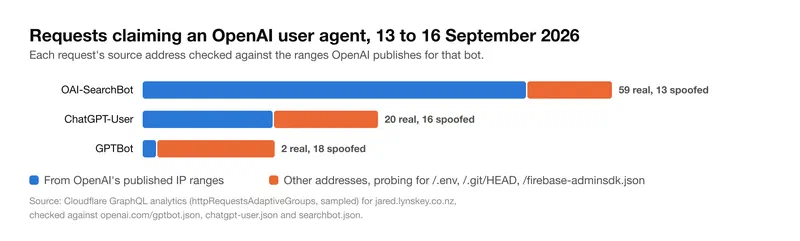
再说假冒的。自称 GPTBot 的 20 个请求里,有 18 个来自 OpenAI 公布的地址段之外,要的是 /.env、/.git/HEAD 和 /firebase-adminsdk.json。36 个 “ChatGPT-User” 请求里有 15 个是同一路货色。“PerplexityBot” 的流量大多想要 /id_ed25519。user agent 就是一个谁都能发的字符串,漏洞扫描器已经发现 AI bot 的名字会被放行。OpenAI、Anthropic 和 Perplexity 都公布了自己的 IP 段。如果你打算对某个 bot 特殊对待,不管是放还是拦,查地址,别查名字。上面的 20、59 和 8,是从正确地址来的那些请求。
页面不用浏览器也得能读#
检索 bot 在回答的那一刻抓取,有超时,而且大多数不跑 JavaScript。一个在 bundle 加载完之前只是一个空 div 的页面,就是它们读不到的页面。Hugo 输出的是完整的 HTML,所以这个博客白得了这一点,这也是我从没动过心思把它搬到什么更聪明的东西上的主要原因。我做的市场应用是反面例子,一个 React Native 的 Web 应用,为了让爬虫拿到一份真正的文档,先做了一条动态渲染分支,然后又被一个缓存 bug 悄悄抵消了。上面那篇 Cloudflare 的文章讲的就是这事。
速度也是同样的道理,而这里日志纠正了我。我原本以为,静态站放在 Cloudflare 后面,就是从最近的边缘节点出去的。不是。这个博客放在 Cloudflare Pages 上,HTML 是不经缓存发出去的,从首尔发请求,响应从洛杉矶回来,大约要半秒。对一个超时有好几秒的 bot 来说这仍然够用,但它不是我原本会张口就说的几十毫秒,而且我知道这一点只是因为我测了。一个正从六个页面里拼答案的助手,会把那个要花三秒的丢掉,而且不会告诉你它丢了。
写得让一段话能单独被摘出来#
这些系统用页面的方式和读者不一样。它们把页面切成块,给每块按问题打分,引用得分高的那些。一篇用八百字铺垫到结论的文章,每一块的分都低。一篇每一节第一句就亮出观点、后面再论证的文章,会在匹配的那一节得分。
这件事对我在这里写东西的影响,比任何技术上的事都大。front matter 里的 description 现在是对文章内容的概括,不是勾你点进来的钩子,因为 description 往往是助手唯一展示的部分。小节标题说的是这一节的结论。数字连同单位写进句子,而不是放在图表里。日期写全,因为"上周"对一年后读这页的模型来说什么都不是。还有,一篇文章只讲一件事。
另一半是要有值得引用的东西,而这里的数据是掺杂的。日志里,回答时的 bot 抓的都是具体的那些页面:Fly.io 冷启动、更新服务器、iOS 调试。Naver 的爬虫叫 Yeti,Daum 的叫 Daumoa,Fly.io 的机器重启是一个 30 秒的 504 窗口,Cloudflare 在线做的 Brotli 在我的 bundle 上测出来比 gzip 还差。这些事实没几个地方写过,所以需要其中某一条的问题就会落到这里。可是从助手那边点进来的人,大多落在 2023 年和 2024 年那些讲管理的文章上,每篇一两个会话。具体的文章被机器读,泛泛的文章拿到点击。这我给不出一个利落的解释,宁可照实报出来,也不想编一个。杠杆要是有的话,仍然是把你这周弄明白的、当初搜也搜不到的那件具体的事写下来,因为机器明摆着读的就是这些。
说清楚是谁写的,而且每次都说一样的#
一个助手在决定要不要引用一个页面时,做的事和一个认真的读者差不多:这是谁写的,什么时候写的,和我找到的其他东西对得上吗?这个站上这部分的机制大多是主题的功劳。每篇文章都带 Article 结构化数据,有作者、发布日期和修改日期,作者是一个 Person,链接到同一个 GitHub 和 LinkedIn 主页。这在模板里只是几行,却是"一个页面"和"一个有来历的、署了名的人写的页面"之间的区别。
不是主题功劳的那部分是一致性。关于页、llms.txt、LinkedIn 主页和每篇文章顶上的那一行,描述的都是同一个人,同一段工作经历。有东西变了,就全都要改,不然忘掉的那个就成了错的那个。听起来挺较真,但一个页面说我是工程经理、另一个说我是自由职业,正是那种会让模型含糊其辞、或者干脆换个人引用的矛盾。
修改日期也得老实。内容变了它才变,否则我不碰它。为了显得新鲜而去改它,是那种管用一次、然后整个域名都被打折扣的事。
llms.txt,还有没人读它这件事#
llms.txt 是 2024 年 9 月提出的一个方案:在站点根目录放一个 Markdown 文件,给语言模型一段站点概述和一份精选的链接列表。我今年 2 月加了一份。开头一段讲我是谁,然后按管理、基础设施、移动和社区分节,每篇文章一行:标题、URL,加一句话说这篇文章的结论。读起来像一份写给赶时间的人的目录。
要说明的是,没人读它。在我手上这四天的日志里,请求过 /llms.txt 的只有我自己。Common Crawl 在 2026 年 8 月那一轮抓取里收了这个站的 76 个页面,从来没收过这个文件。没有哪家主要的助手说过它会读它。所以这里有什么被引用都不是因为它,我也不会以此为由推荐给任何人。留着它有两个原因。它只花了一个小时,而且给每篇文章写一句"这篇到底得出了什么结论",比文件本身更值,因为它让我看到了哪些文章什么结论都没有。它也是站上唯一一个告诉机器这个站是干什么的页面,我宁愿有它而用不上。之后它已经跑偏了,因为我是手写的,会忘,这也是应该改成用 Hugo 的输出格式从 front matter 生成它的理由。这事在清单上。
Feed、sitemap 和五种语言#
无聊的管道照样算数。sitemap 是爬虫在新文章上线当天找到它的方式。RSS 是它得知一篇文章改过的方式。两个都是 Hugo 的默认,我从没需要操心。ClaudeBot 两天里读了 36 次 sitemap,它就是这样那么快找到 1,380 个页面的。
语言是我没料到会有影响的部分。这里的所有内容都有英语、日语、韩语、简体中文和越南语版本,带 alternate 链接,让爬虫知道它们是同一篇文章。爬虫把它们当成五个站:ClaudeBot 的抓取几乎是在五种语言之间平分的,Common Crawl 8 月收走的 73 个文章页面里,只有四个是英语的。助手用被提问的语言回答,也偏向那种语言的来源,所以一个关于 Fly.io 冷启动的韩语问题,可以直接从韩语页面回答,而不是现场把英语页面翻一遍,而 ChatGPT 实际抓走的正是日语那一页。条件是译文读起来得像用那种语言写的。今年早些时候我请母语者帮着检查做的那一遍修订,本来是为了人类读者,但也正是它让越南语页面成了一个来源,而不是一个稀奇玩意儿。
我能测量什么#
比我以为的多,只要别再靠猜。Cloudflare 的免费套餐给的是按 user agent 和路径分的请求日志,一次查询一天,上面那张 bot 表就是从这来的;referrer 要付费套餐才有。Google Analytics 有 referrer,通过它的 API 把数据拉出来,而不是眯着眼看仪表盘,开头那些数字就是这么来的。两边合起来能看出个大致轮廓。四天里,检索 bot 从 OpenAI 和 Anthropic 的地址抓了大约九十个页面。上一个月,有两个人从 ChatGPT 过来。读得多,偶尔引,很少点。据我所知,还是没有办法看到那些用了某个页面却没被点击的回答。最有用的检查依然是手动的那种:拿你文章回答的那个问题去问助手,看它引的是谁的页面。
如果这一切里只能留一样,我留写作那条规则。robots.txt、结构化数据和 llms.txt 是一个下午的活,做完就完了。让每一节先说观点,写具体的事而不是泛泛的事,是一种习惯,而正是这个习惯决定了一个页面到底值不值得引用。第二样是:先测了再说。被机器信任,结果看起来和被人信任很像:说你是谁,说你知道什么,而且每次都用同一种说法。