想象一个小团队在做同一个应用。两个开发者也好,五个也好;不是分工不同的专家,而是各自在自己的分支上把一个功能从数据库迁移、经过 API、一直做到移动端界面,端到端地负责的人。这是运转团队的好方式,而从第二个开发者加入起,它就有一个反复出现的故障:“现在有人在用 staging 吗?“这条消息。
消息背后是一个做完了功能、想给测试或设计看、却看不了的开发者:staging 上跑着第二个开发者的分支,dev 上跑着第三个的,而那个分支两天前把登录搞坏了,之后就再没重新部署过。几个人,两个共享环境,一条 Slack 线程在负责排班。
这不是人的问题,是拓扑问题。每个开发者都把环境当作"我的分支变成真的"的地方,于是环境在替 merge 干活,一次一个分支,其他所有人排队等着。
我的技术栈在生产中的样子写在 My Current Stack 里:Fly.io 最便宜的机器上用 Granian 跑 Django,PgBouncer 后面的 Fly Postgres,给缓存和 Channels 层用的 Redis,独立的 WebSocket 应用,跑后台任务的 db_worker,放文件的 Tigris,Firebase Auth,前面挡着 Cloudflare,还有一个和这一切通信的 Expo 应用。这篇文章讲的是我怎么把这套栈变成这样一种东西:任何分支,开发者往 PR 上打一个标签,几分钟后就拿到一份带 HTTPS 的、公开可访问的完整副本,不用求别人,也没人替他开通,而且不需要第二个 Postgres 集群、第二个 Redis 或第二个 bucket。基础设施保持共享。变化的是每一种共享资源都学会了按名字切片,而名字来自分支。这里面没有任何东西预设团队规模:两个开发者和二十个开发者用的是同一套设计,会增长的只有应用列表,而那由清扫器来处理。我在一个下午里把它搭起来,同时跑了三个分支,在两个没预料到的地方把它弄坏,又拆掉了;下面的输出都来自那次运行。
为什么一个共享环境撑不过一个开发者#
共享的 dev 环境里烙着一个假设:所有人想看的"当前代码版本"只有一个。对单个开发者,或者对齐步推进同一条变更流的团队来说,这是对的。第二个开发者按另一个时间表开始做功能的那一刻,它就不对了;而在端到端负责制下,每个功能都是这样。从那以后,环境里的一切都成了争抢对象:
- 部署的代码。 最后部署的人赢。其他人的工作在重新部署前都看不见,而重新部署又会抹掉前一个人的。
- 数据库 schema。 当每个开发者都拥有自己功能的数据模型时,咬得最狠的就是这一条。第一个分支加了一列。一小时后部署的第二个分支不知道有这列,ORM 开始在 insert 上报错。或者两个分支都有一个
0042_*迁移,共享数据库落到一个和谁的迁移历史都对不上的状态,然后有人把它重置,顺手删掉了第三个开发者花一下午准备的测试数据。 - 缓存。 一个分支改了序列化器,结果缓存到了另一个分支代码读取的同一个 Redis 键下。由此产生的 bug 报告莫名其妙,每个都要耗掉一上午。
- 第三方集成。 一个 OAuth 回调,一个 webhook URL,一个推送证书。谁的分支部署着,谁就收到事件。
- 测试人员。 他们只能测已经部署的东西,所以是按环境碰巧被谁占用的顺序、而不是功能就绪的顺序,一次测一个。
团队的应对是预约制:一条 Slack 线程、一条置顶消息、一个 /claim staging 机器人。那是一把锁,而锁在唯一能展示你工作的地方上,就是锁在交付速度上。两个开发者的话,只是烦人。三个的话,顺利的一周还能忍。加一个第四人,或者某个功能因为要和设计师来回三天而一直霸着 staging,就忍不了了。
人们最先想到的办法是再加一个共享环境,“dev2” 或者 “uat”。这能争取几周。队伍只是变成了两条道。
真正的解法是意识到 dev 和 staging 从来就不是环境。它们是某人分支的当前状态,附带一个 URL。如果它们是这样的东西,那它们的正确数量就是团队此刻在意的分支数,正确寿命就是分支的寿命。
模型:分支就是环境#
目标状态是这样。
| 环境 | 数量 | 由谁创建 | 由谁销毁 | 存活时间 |
|---|---|---|---|---|
| 分支环境(原来的"dev”) | 每个活跃分支一个 | 分支的 PR 上的 env 标签,之后每次 push;没有 PR 的 spike,就手动跑同一个 ./scripts/env up | 删除分支,外加每晚的清扫器 | 几天 |
| Staging | 每个发布候选一个 | 从 main 打 tag 时由 CI | 同一镜像晋升到生产后由 CI | 几小时 |
| 生产 | 一个 | 你,一次 | 没人 | 永远 |
再看一遍表里谁创建、谁销毁:每一项要么是 git 事件,要么是时钟。git 就是控制平面。应该存在的环境集合直接由存在的分支集合决定,自动化唯一的工作就是让现实和它保持一致:PR 上的标签创建,之后每次 push 更新,关闭或合并 PR 销毁,每晚一个任务把前三者漏掉的收拾干净。也不是每个分支都会有环境:标签就是闸门,开发者点一下,所以备份用的 push 或机器人的依赖升级不花一分钱。没有人在开通环境。不是拿着工单的 DevOps 工程师,不是你在 Slack 里喊的机器人,也不是你每次都要提示一遍的 AI agent。第十个开发者的第一个分支拿到环境的方式,和第一个开发者的一模一样:PR 被打上了标签。如果还得去找一个人,那就没有扩展,只是队伍换了个地方排。
让它成立的规则只有一条:环境触及的每一种资源都按分支命名,且是确定性的。 不按开发者,不按工单,也不按那个没人开 PR 之前根本不存在的 PR 号。按分支,因为分支才是开发者实际打交道的东西,也因为名字确定,就意味着在同一分支上第二次运行 ./scripts/env up 会找到已经建好的环境,而不是再建一个。
名字是给人看的 slug 加上保证唯一的短哈希:
branch=$(git rev-parse --abbrev-ref HEAD)              # feature/payments-retry
slug=$(printf '%s' "$branch" | tr '[:upper:]/_ ' '[:lower:]---' | tr -cd 'a-z0-9-' | cut -c1-20)
hash=$(printf '%s' "$branch" | sha256sum | cut -c1-6)
ENV="${slug%-}-${hash}"                                 # feature-payments-retr-3f9a1c
feature-payments-retr-3f9a1c 就是环境。这个字符串会成为 Fly 应用名、Postgres 数据库名(连字符换成下划线)、Redis 键前缀、Tigris 对象前缀、Sentry 的 environment,以及主机名最左边的标签。知道分支名的任何人都能算出来。什么都不用查。
最后那句话就是设计本身。没有环境注册表,没有协调者。env up、env down、负责路由主机名的 Cloudflare Worker,以及每晚的清扫器,各自独立地从分支重新算出名字,靠构造保证一致。尤其是 Cloudflare,它什么都不协调:Worker 是一个从主机名到 Fly 应用的纯函数,它永远不知道某个环境被创建或销毁了。应用存在,请求就落地;不存在,Fly 用自己的错误来回答。
由此得出三件事。
第一,“谁在用 staging"不再是个问题。有 feature-payments-retr-3f9a1c-dev.marucommunity.com,有 fix-login-redirect-8b21e0-dev.marucommunity.com,各归在那个分支上的人所有。
第二,staging 从垃圾场变成了对生产的诚实彩排。它用即将上生产的那个镜像构建,对着几分钟前从生产形态快照克隆出来的数据库跑。那里能跑通,生产里剩下的唯一变量就是生产数据。
第三,每个开发者获得了权力,却不需要任何共享资源的 root。分支环境的爆炸半径就是那个分支环境。第四个新人入职第一天想往自己分支上部署什么都行,最坏的结果是自己的分支坏了。
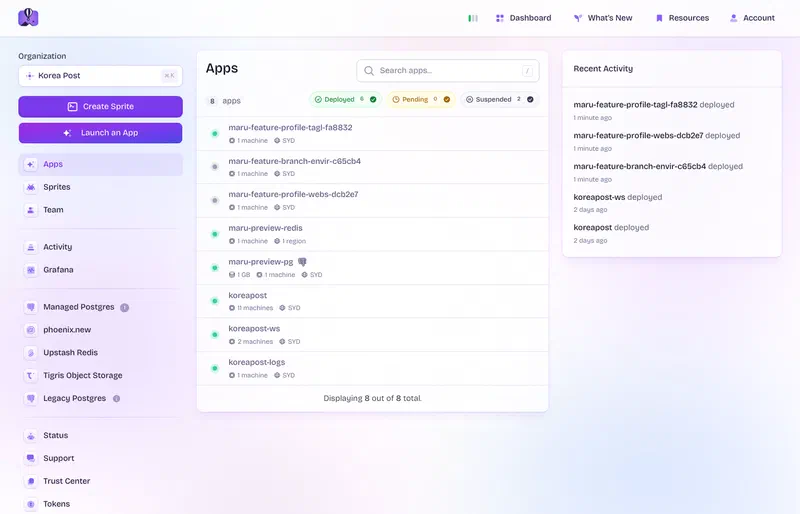
koreapost 几行是生产。物理上共享,逻辑上隔离#
“每个分支一个环境"的诱人版本是整套复制:每人一个 Postgres 集群、一个 Redis、一个 bucket。干净,但是笔坏买卖。一个 Fly Postgres 集群是一台机器加一个卷加一次恢复;一个 Redis 又是一台机器;你会为每个环境等上几分钟,并为十来个闲置数据库付钱。清扫器要清理的东西也从一种变成四种。
取而代之的是,每种共享服务为整个预览组织只配置一次,按小号生产的规格来,每个环境以 $ENV 为键分到一片。这是我想贴在墙上的表:
| 资源 | 共享的东西 | 每个环境独有的 | 靠什么保证 |
|---|---|---|---|
| 计算 | Fly 组织 maru-preview | 一个 Fly 应用 maru-$ENV,一台机器 | Fly:应用是隔离单位 |
| 密钥 | Fly 的按应用密钥存储 | 应用自己的密钥;SECRET_KEY、FIELD_KEY 和 ENV_TOKEN 是按环境生成的,不是复制的 | Fly:密钥属于应用,机器只能读自己的 |
| Postgres | 一个 Fly Postgres 集群 maru-preview-pg | 一个数据库 env_feature_payments_retr_3f9a1c,从 seed_template 克隆 | Postgres:数据库是硬边界,不能跨库查询 |
| Redis | 一个 Upstash/Fly Redis | 缓存和 Channels 层上的键前缀 feature-payments-retr-3f9a1c: | Django KEY_PREFIX,channels_redis 的 prefix |
| 文件 | 一个 Tigris bucket maru-preview | 对象前缀 feature-payments-retr-3f9a1c/ | django-storages 的 location;预签名 URL 本来就限定到单个键 |
| 主机名 | 区域里已有的、已代理的 *.marucommunity.com 记录 | 最左边的标签 <env>-dev | *-dev.marucommunity.com/* 上的一条 Cloudflare Worker 路由 |
| 认证 | 一个 Firebase 项目 maru-dev | 无;用户身份是有意共享的(见下文) | 授权域名 marucommunity.com |
| 错误与日志 | 一个 Sentry 项目,Fly 的日志 | 所有东西都打上 environment=$ENV 标签 | 配置 |
其中两行值得多说一句。
Postgres:用数据库,不用 schema。 切分单个集群的另一种做法是每个环境一个 schema,按连接设置 search_path。把 -c search_path=... 塞进连接的 options 里,Django 是能做到的,但事务池模式下的 PgBouncer 会丢弃启动参数,除非你专门告诉它别丢,而即便如此,池里的每个连接也终究只能属于一个环境。这是"为什么我的查询打到了别的表"这类 bug 的源头,而每个环境一个数据库根本不存在这个问题。数据库是硬边界,CREATE DATABASE ... TEMPLATE 几秒钟建一个,DROP DATABASE 把它删得一干二净。分支环境不走 PgBouncer,直接连 Postgres 的 5433 端口,和生产里的 db_worker 一样;连接池是在生产级并发下才值回票价的,而分支环境永远见不到那种并发。
密钥:生成,不共享。 弄一套 dev 密钥复制到每个环境里当然省事。别这么干。env up 脚本为每个环境生成新的 SECRET_KEY(会话签名)、FIELD_KEY(所有静态加密的东西)和 ENV_TOKEN(移动端出示的 bearer 令牌,下文详述),只存在那个 Fly 应用的密钥存储里。这意味着一个分支的会话 cookie 在另一个分支上一文不值,泄露的预览令牌只能打开一个预览,开发者不特意去找就永远看不到这些值。如果你把密钥放在 1Password 或 Doppler 之类而不只是 Fly 里,规则一样:路径是 maru/preview/$ENV/,清扫器会连同环境一起删掉这条路径。真正跨环境共享的密钥只有共享基础设施本身的凭据(Postgres 管理员 URL、Redis URL、Tigris 密钥),而这些放在 CI 里,不在任何环境里。
Redis 那一行最容易让人怀疑,所以做了测试。从一个环境里面设一个缓存键,从另一个读,再列出共享 Redis 里的所有键:
$ fly ssh console -a maru-feature-profile-tagl-fa8832 -C "python manage.py shell -c \"from django.core.cache import cache; cache.set('who-am-i','tagline-branch',600)\""
$ fly ssh console -a maru-feature-profile-webs-dcb2e7 -C "python manage.py shell -c \"from django.core.cache import cache; print(cache.get('who-am-i'))\""
None

$ # every key in the shared Redis, scanned from the website machine
  feature-profile-tagl-fa8832:1:who-am-i
  release:89112c88f7da008e:done
  ...
同一个 Redis,同一个键名,另一个环境什么都看不到。(列表里的 release:* 键就是我上面提到的发布闸门 bug,正是这次扫描抓到的;现在它们已经在前缀下面了。)
这篇文章剩下的部分,就是把 $ENV 盖到那八行上的脚本,以及让它保持诚实的规则。
./scripts/env up#
这就是全部——一个开发者在自己分支上运行的脚本。CI 运行的是同一个脚本;没有会各自漂移的 CI 专用路径。笔记本上只需要 fly 和 git,别的都不要:SQL 通过 fly ssh 送到 Postgres 应用,环境的 Redis 键和 Tigris 对象在销毁前由环境自己的机器删除,所以笔记本除了一个被 gitignore 的 .env.preview 之外,不持有任何共享 Redis 或 bucket 的凭据。
#!/usr/bin/env bash
# scripts/env up|down|name|url — one environment per branch on shared preview infrastructure
set -euo pipefail
cd "$(git rev-parse --show-toplevel)"
[[ -f .env.preview ]] && { set -a; source .env.preview; set +a; }   # shared-infra credentials; CI secrets in Actions

ORG=${PREVIEW_ORG:-korea-post}
PREVIEW_PG_APP=${PREVIEW_PG_APP:-maru-preview-pg}
BASE_DOMAIN=${BASE_DOMAIN:-marucommunity.com}

branch=${BRANCH:-$(git rev-parse --abbrev-ref HEAD)}
[[ "$branch" == "main" ]] && { echo "main has no branch environment; it has staging" >&2; exit 1; }

slug=$(printf '%s' "$branch" | tr '[:upper:]/_ ' '[:lower:]---' | tr -cd 'a-z0-9-' | cut -c1-20); slug=${slug%-}
hash=$(printf '%s' "$branch" | shasum -a 256 | cut -c1-6)
ENV="${slug}-${hash}"
[[ -n "${ENV_OVERRIDE:-}" ]] && ENV="$ENV_OVERRIDE"       # the sweeper only knows the name
APP="maru-${ENV}"
DB="env_${ENV//-/_}"
HOST="${ENV}-dev.${BASE_DOMAIN}"

pg() { fly ssh console -a "$PREVIEW_PG_APP" -q -C "psql postgres://postgres:${PREVIEW_PG_PASSWORD}@localhost:5433/postgres -At -c \"$1\""; }

up() {
  echo "== $branch -> $ENV"
  # 1. Compute. Idempotent: an app that exists is left alone.
  fly apps list --org "$ORG" --json | grep -q "\"Name\": *\"$APP\"" || fly apps create "$APP" --org "$ORG"

  # 2. Database: clone the seed template unless this branch already has one.
  if [[ "$(pg "SELECT 1 FROM pg_database WHERE datname='$DB'")" != "1" ]]; then
    pg "CREATE DATABASE $DB TEMPLATE seed_template"
  fi
  DATABASE_URL="postgres://postgres:${PREVIEW_PG_PASSWORD}@${PREVIEW_PG_APP}.flycast:5432/${DB}"

  # 3. Secrets. Generated ones are generated once; a later `up` must not rotate them.
  existing=$(fly secrets list -a "$APP" --json 2>/dev/null | grep -o '"Name": *"[^"]*"' | cut -d'"' -f4 || true)
  gen() { grep -qx "$1" <<<"$existing" || printf '%s=%s\n' "$1" "$(openssl rand -hex 32)"; }
  {
    gen SECRET_KEY
    gen ENV_TOKEN
    cat <<S
ENV_NAME=$ENV
ALLOWED_HOSTS=$HOST,$APP.fly.dev
CSRF_TRUSTED_ORIGINS=https://$HOST,https://$APP.fly.dev
DATABASE_URL=$DATABASE_URL
REDIS_URL=$PREVIEW_REDIS_URL
BUCKET_NAME=$PREVIEW_BUCKET
AWS_ENDPOINT_URL_S3=https://fly.storage.tigris.dev
AWS_ACCESS_KEY_ID=$PREVIEW_AWS_ACCESS_KEY_ID
AWS_SECRET_ACCESS_KEY=$PREVIEW_AWS_SECRET_ACCESS_KEY
WS_URL=wss://$HOST
S
  } | fly secrets import -a "$APP" --stage

  # 4. Deploy the working tree, stamped with what it is.
  fly deploy -a "$APP" --config fly.preview.toml --remote-only --ha=false \
    --build-arg GIT_SHA="$(git rev-parse --short HEAD)" --build-arg GIT_BRANCH="$branch" \
    --image-label "$(git rev-parse --short HEAD)"
  echo "https://$HOST"
}

down() {
  [[ "$APP" =~ ^maru-[a-z0-9-]+-[0-9a-f]{6}$ ]] || { echo "refusing to destroy $APP" >&2; exit 1; }
  if fly apps list --org "$ORG" --json | grep -q "\"Name\": *\"$APP\""; then
    fly machine start -a "$APP" >/dev/null 2>&1 || true
    fly ssh console -a "$APP" -q -C "python manage.py env_teardown" || echo "warning: self-teardown failed; the sweeper will catch stragglers" >&2
    fly apps destroy "$APP" --yes
  fi
  pg "SELECT pg_terminate_backend(pid) FROM pg_stat_activity WHERE datname='$DB'" >/dev/null || true
  pg "DROP DATABASE IF EXISTS $DB" || true
}

case "${1:-}" in up) up ;; down) down ;; name) echo "$ENV" ;; url) echo "https://$HOST" ;; esac
演示时我是从笔记本上直接跑的,而不是 push,因为这三个分支是一次性的,我不想让它们留在仓库历史里,也想盯着输出一行行出来。团队里用的时候没人会敲这条命令:下文的标签工作流跑的就是这个脚本,接下来的输出就是会落在 Actions 日志里的那些。这是它第一次在承载这套工具本身的分支上运行时打印的内容:
$ ./scripts/env up
== feature/branch-environments -> feature-branch-envir-c65cb4
New app created: maru-feature-branch-envir-c65cb4
creating database env_feature_branch_envir_c65cb4 from seed_template
CREATE DATABASE
Secrets have been staged, but not set on VMs. Deploy or update machines in this app for the secrets to take effect.
==> Building image with Depot
image: registry.fly.io/maru-feature-branch-envir-c65cb4:87c061b9
image size: 139 MB
> Machine 865529aee76918 [app] was created
✔ Machine 865529aee76918 [app] update finished: success
https://feature-branch-envir-c65cb4-dev.marucommunity.com

$ curl -s https://feature-branch-envir-c65cb4-dev.marucommunity.com/api/version/
{"environment": "feature-branch-envir-c65cb4", "branch": "feature/branch-environments", "commit": "87c061b9",
 "image": "registry.fly.io/maru-feature-branch-envir-c65cb4:87c061b9", "app": "maru-feature-branch-envir-c65cb4", "region": "syd"}
从命令到 URL 大约两分半,大部分是镜像构建。再提交一次后在同一分支上第二次 up,没有打印 “New app created”,也没有 “creating database”,暂存了同样的密钥名而没有重新生成那两个生成的,然后重新构建:同一个 URL,新的提交。
里面的几个选择各值得一句话。
fly.preview.toml 不是 fly.toml。 生产把 API、WebSocket 服务器和 db_worker 作为独立的 Fly 应用和进程组来跑,各按自己的指标伸缩,那正是技术栈那篇的全部论点。分支环境不需要伸缩;它需要的是一台机器。所以预览配置只有一个进程,entrypoint.sh 多了一个 granian-preview 模式,先跑发布闸门和迁移,再以 ASGI 带 --ws 启动一个 Granian。asgi.py 里的 ProtocolTypeRouter 本来就同时路由 http 和 websocket,所以一个进程就能服务整个应用。那个模式下同步视图以 thread_sensitive 运行,差不多一次一个请求——正是我在生产里放弃的那笔交易,而在这里恰恰合适,因为测试分支的人不会察觉。
# fly.preview.toml (the app name is supplied by `fly deploy --app`)
app = 'branch-environment-placeholder'
primary_region = 'syd'

[processes]
  app = "granian-preview"

[env]
  DJANGO_SETTINGS_MODULE = 'koreapost_project.settings'
  DEBUG = 'False'
  WEB_BUNDLE_FROM_BUCKET = '0'     # the image's own web bundle; the preview bucket never holds one

[http_service]
  internal_port = 8000
  force_https = true
  auto_stop_machines = 'suspend'
  auto_start_machines = true
  min_machines_running = 0
  [[http_service.checks]]
    path = '/api/health/'
    [http_service.checks.headers]
      Host = '127.0.0.1'           # base.py allows loopback; the app's own hostname isn't known to a static file

[[vm]]
  size = 'shared-cpu-1x'
  memory = '1gb'
auto_stop_machines = "suspend",min_machines_running = 0。 午饭后没人打开过的分支环境应该一分钱不花。用 suspend 而不是 stop,得到的是我追查 504之后落到的约 3 秒恢复,而不是 30 秒冷启动,而在这里就算 30 秒也能接受。三个演示环境里有两个在部署完成一分钟后就已经在 fly apps list 里显示 suspended 了。
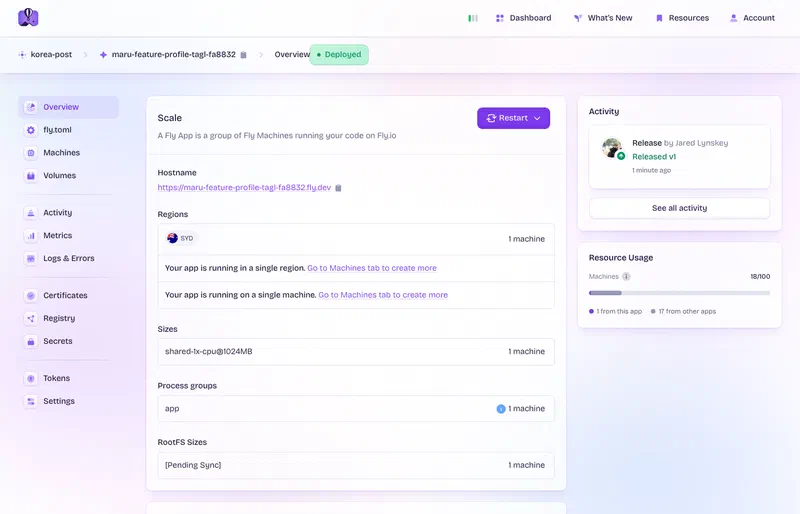
DEBUG = False,和生产同一个 settings 模块。 分支环境是一个公开 URL。在所有对测试重要的方面(真 HTTPS、真 cookie、同样的健康检查)它都应该像生产,在所有可能伤到人的方面它都应该不像生产。差异不靠单独的 preview.py,而是由 env up 设置的密钥承载:沙箱支付密钥、没有 Firebase 管理员凭据,以及打开下面所有前缀的 ENV_NAME。
一个设置切分一切。 ENV_NAME 是 settings/base.py 里唯一新增的旋钮,应用在四个地方:
ENV_NAME = os.getenv("ENV_NAME", "")
_ENV_PREFIX = f"{ENV_NAME}/" if ENV_NAME else ""

CACHES["default"]["KEY_PREFIX"] = ENV_NAME                     # every cache key, and the list-cache version counters
CHANNEL_LAYERS["default"]["CONFIG"]["prefix"] = f"{ENV_NAME}:asgi"  # group and channel names
STORAGES["default"]["OPTIONS"]["location"] = f"{_ENV_PREFIX}media"  # uploads
STORAGES["staticfiles"]["OPTIONS"]["location"] = f"{_ENV_PREFIX}static"
漏掉 channels 那一处,两个分支的 WebSocket 服务器就会共用组名,一个环境里发的消息会出现在另一个环境里。那是要耗掉一天的那种 bug。
第五处是事后读共享 Redis 才发现的。504 那篇里的发布闸门——让每个镜像只有一台机器跑迁移、其他机器等待的机制——用镜像引用的哈希做锁的键。从同一个提交构建的两个分支环境有同一个镜像。第二个会找到第一个的 “done” 标记,然后跳过它自己对自己那个尚未迁移的数据库的迁移。现在环境名是被哈希的值的一部分,键也住在前缀下面。这是共享基础设施设计会不断产出的那类问题:所有隐含地"按部署"的东西都得显式地变成按环境,而在你去看之前,你不知道什么是隐含的。
数据库是克隆的,不是从空库迁移的。 下一节。
数据库:几秒克隆出来的模板#
分支环境的数据库有三种可能。和所有人共享——这正是把我们带到这里的东西。空库,从零迁移再用 fixture 填充:确定性强,但 fixture 从来比不上真实形态的数据,而且永远陈旧十八个月。或者克隆一份生产形态的快照:真实的行数,fixture 假定总是有值的那些列里真实的 null,在空表上瞬间完成、在真表上要跑四十分钟的迁移会现出原形。
选第三种,第二种保留为只在 CI 跑的检查。而让第三种快到可以每个分支都做一次的,是一个大多数人忘了存在的 Postgres 功能:
-- Nightly, on maru-preview-pg. Restore last night's prod backup into seed_raw,
-- run the anonymiser, then freeze it as a template nobody can connect to.
ALTER DATABASE seed_raw RENAME TO seed_template;
UPDATE pg_database SET datistemplate = true, datallowconn = false WHERE datname = 'seed_template';

-- Per branch, in the time it takes to copy the files:
CREATE DATABASE env_feature_payments_retr_3f9a1c TEMPLATE seed_template;
CREATE DATABASE ... TEMPLATE 是集群内的文件级复制。几个 GB 只要几秒,而不是 pg_restore 的几分钟。被克隆时模板不能有打开的连接,datallowconn = false 强制了这一点,这也是为什么夜间任务往 seed_raw 里构建、最后再改名,而不是直接往活着的模板上恢复。
演示里模板是手工建的,而不是来自生产 dump:用 fly proxy 打一条通向预览集群的隧道,manage.py migrate,然后用仓库自带的填充命令生成分类体系、一对带对话的买家和卖家、二十条社区帖子。十九兆。三个分支起来时,集群里出现了它的三个克隆,每个 19 MB,每个不到一秒:
$ fly ssh console -a maru-preview-pg -C "psql ... -c '\l'"
             datname             | template | size
---------------------------------+----------+-------
 env_feature_branch_envir_c65cb4 | f        | 19 MB
 env_feature_profile_tagl_fa8832 | f        | 19 MB
 env_feature_profile_webs_dcb2e7 | f        | 19 MB
 seed_template                   | t        | 19 MB
预览集群是一个非托管的 Fly Postgres 节点,shared-cpu-1x 带 1 GB 卷,每月大约两美元。分支环境通过私有网络的 .flycast 连它;没有任何东西是公开的。
匿名化不是可选项。生产数据在 -dev 主机名上可达的那一刻,它就必须不再是生产数据:姓名、邮箱、电话、地址、自由文本、支付引用、令牌,全部在改名之前覆盖掉。匿名化失败,前一晚的模板保留,有人会收到消息。这是件小活,也正是让整个方案能被回答隐私问卷的那个人接受的那件活。
entrypoint.sh 里的发布闸门在每个镜像首次启动时运行 migrate,所以分支自己的迁移会叠加在模板之上。这是"我的迁移在生产形态的数据上能不能跑"的第一次诚实测试,而且发生在任何人打开 URL 之前。
主机名:一个通配符、一个 Worker,以及文档没告诉我的两件事#
每个环境都需要一个公开的 HTTPS 主机名,而"公开"正是重点:拿着手机的测试、另一个网络里的设计师、不肯装 VPN 的产品经理。Fly 免费给每个应用一个 maru-$ENV.fly.dev,光靠它也能用。但 *.fly.dev 主机名有三个问题:发出去难看,前面没有 Cloudflare 所以你在生产上的所有防护都不生效,而如果想放到自己的域名下,就得每个环境一条 DNS 记录加一张证书,清扫器又多一样要清的东西。
把这些都去掉的版本,是一个通配符加一个 Cloudflare Worker。我原计划用 *.dev.marucommunity.com。两件事挡住了它,而且在你做同样的计划之前,两件都值得知道。
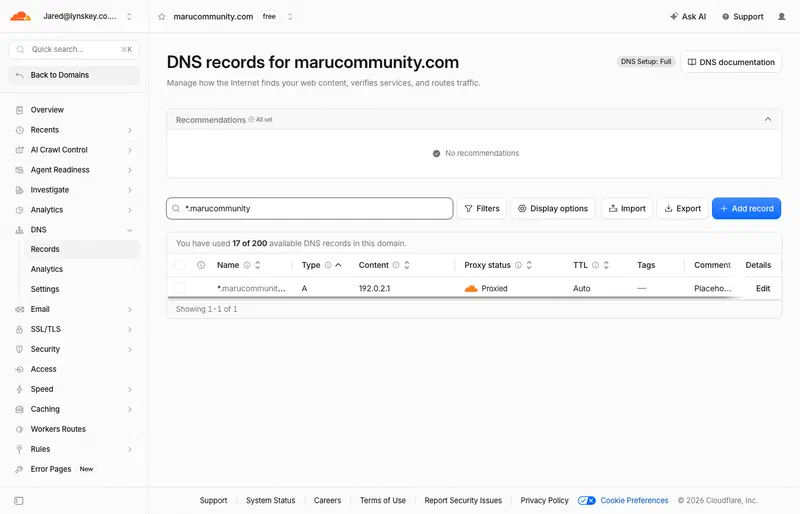
Universal SSL 只覆盖一层通配符。 Cloudflare 的免费证书签发给 marucommunity.com 和 *.marucommunity.com。它不覆盖 *.dev.marucommunity.com;二级通配符需要每月 10 美元的 Advanced Certificate Manager。对 feature-branch-envir-c65cb4.dev.marucommunity.com 的第一个请求在我的任何东西运行之前就死于 SSL 握手失败。解法是把环境留在第一层标签里:feature-branch-envir-c65cb4-dev.marucommunity.com。它被已经存在的证书覆盖,也被已经存在的、已代理的 *.marucommunity.com 记录覆盖——就是我为扫描杜撰子域名的爬虫设的那个黑洞记录。所以一个环境完全不需要 DNS。
Redirect Rules 在 Workers 之前执行。 路由配好之后,每个 -dev 主机名都在 Worker 没有运行的情况下 301 到了 www 首页。黑洞是一条区域级的重定向规则,“其他任何子域名 → www”,而 Cloudflare 的重定向阶段在 Workers 阶段之前执行。规则需要加一个子句:and not ends_with(http.host, "-dev.marucommunity.com")。部署脚本在 up 时加上、down 时去掉,因为手工改过的规则正是会被遗忘的东西。
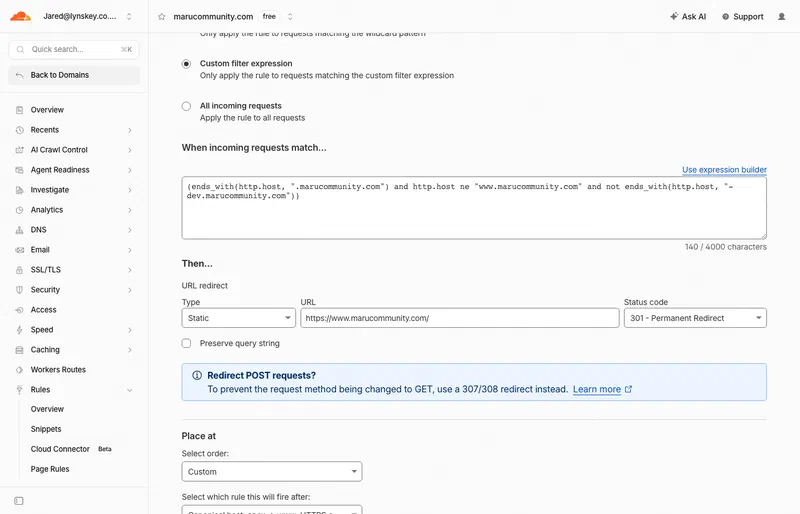
-dev.marucommunity.com 结尾的主机名会漏过去交给 Worker。DNS 这边就是那条本来就在的记录:
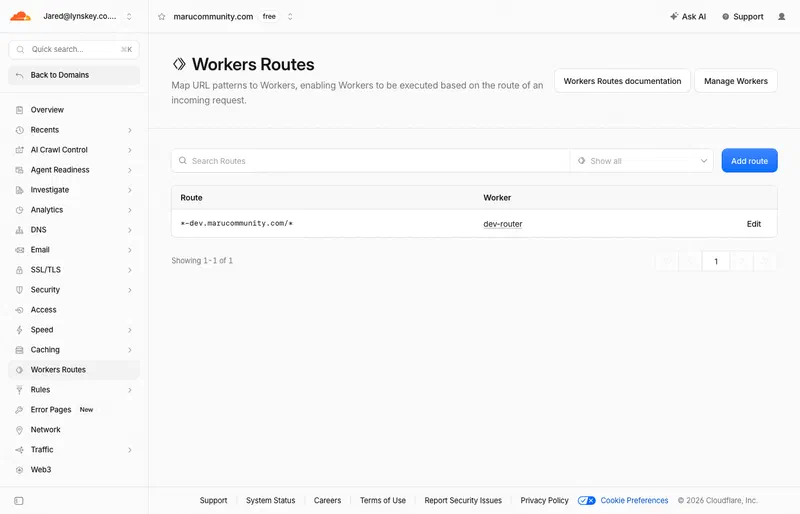
这两件事解决后,路由就是 *-dev.marucommunity.com/* 上的一个 Worker:
// infra/dev-router.js — <env>-dev.marucommunity.com -> maru-<env>.fly.dev
const DEV_SUFFIX = "-dev.marucommunity.com";
const ENV_NAME = /^[a-z0-9-]+-[0-9a-f]{6}$/;   // slug-hash, as scripts/env names them

export default {
  async fetch(request) {
    const url = new URL(request.url);
    if (!url.hostname.endsWith(DEV_SUFFIX)) return new Response("not a dev hostname", { status: 404 });
    const env = url.hostname.slice(0, -DEV_SUFFIX.length);
    if (!ENV_NAME.test(env)) return new Response(`no such environment: ${env}`, { status: 404 });

    url.hostname = `maru-${env}.fly.dev`;
    const upstream = new Request(url, request);
    upstream.headers.set("X-Forwarded-Host", request.headers.get("host") ?? "");

    const res = await fetch(upstream);
    const out = new Response(res.body, res);
    out.headers.set("X-Robots-Tag", "noindex, nofollow");   // a half-finished branch is not for search engines
    out.headers.set("X-Dev-Environment", env);
    return out;
  },
};
Cloudflare 在通配符上终结 TLS,Worker 从标签算出 Fly 主机名,到机器那一跳由 Fly 自己的 *.fly.dev 证书覆盖。WebSocket 升级原样穿过 fetch。而由于路由在区域上,Cloudflare 为生产做的一切在这里都可用:WAF 规则、限速、bot 防护模式,以及 Access。
三个分支同时在线,一个 Worker,以及每个主机名的应答:
| 主机名 | HTTP | 路由到 | branch | commit |
|---|---|---|---|---|
feature-branch-envir-c65cb4-dev.marucommunity.com | 200 | maru-feature-branch-envir-c65cb4.fly.dev | feature/branch-environments | 6560ec9a |
feature-profile-tagl-fa8832-dev.marucommunity.com | 200 | maru-feature-profile-tagl-fa8832.fly.dev | feature/profile-tagline | e3baa936 |
feature-profile-webs-dcb2e7-dev.marucommunity.com | 200 | maru-feature-profile-webs-dcb2e7.fly.dev | feature/profile-website | beb08161 |
not-an-env-dev.marucommunity.com | 404 | 无;Worker 拒绝了这个标签 |
每个 200 都带着 Worker 加上的 X-Robots-Tag: noindex, nofollow 和 X-Dev-Environment: <env>。那个 404 是 Worker 自己给的,根本没问过 Fly。
Cloudflare Access 是把"公开"变成"该到的人到得了"的东西。在 *-dev.marucommunity.com 上建一个应用,策略是"任何 @marucommunity.com 邮箱”,浏览器访客看一次登录页,之后就再也不用想它。设计师、PM 和用笔记本的测试就都覆盖了。演示里我没加;那些环境带着 noindex 在线了一小时,上面除了种子数据什么都没有。
它覆盖不了移动端,因为原生应用完不成 Access 的登录跳转。两条路。Access 支持服务令牌(一对 CF-Access-Client-Id / CF-Access-Client-Secret 请求头)绕过登录,Expo 应用的开发菜单可以为 dev 主机名带上一对。或者更简单,为 /api/ 加一条 Access 放行,让 Django 拒绝任何既没有 Firebase 用户、也没有该环境 ENV_TOKEN——就是 env up 专门为这个环境生成的那个——的请求。无论哪种,Expo 这边都是一个带两个字段的开发菜单页,基础 URL 和令牌,测试人员已经装好的应用现在就和那个分支通信了。不需要新构建。OTA 更新通道继续指向应用构建时的那个;API 基础 URL 是运行时设置,不是构建时设置,本来就该如此。
Firebase Auth 是唯一有意共享的共享服务。身份不分环境;测试人员希望在每个分支上都用同一个账号登录。一个授权域名里有 marucommunity.com 的 dev Firebase 项目覆盖所有 -dev 主机名,每个环境都对着它验证 ID 令牌。每个环境数据库里的用户表都是模板用户的副本,所以模板里有的账号,测试人员在哪儿都有。
用 GitHub 自动化:事件进来,环境出去#
上面的一切手工来做,只有你一个人时没问题。一旦有了第二个开发者,它就必须因为 git 里发生了什么而发生,而不是因为有人记得。整套自动化是四个工作流、一个仓库设置、一个规则集和一个 GitHub environment,其中每一个都把某个 git 事件映射到对开发者手工运行的同一个 scripts/env 的调用。没有会漂移的 CI 专用路径。
| Git 事件 | 运行什么 | 做什么 |
|---|---|---|
PR 被打上 env 标签 | branch-env.yml → scripts/env up | 创建该分支的环境,在 PR 上贴出 URL |
| 向已打标签的 PR 的分支 push | branch-env.yml → scripts/env up | 原地更新 |
| 标签被移除、PR 关闭或合并 | branch-env.yml → scripts/env down | 环境清理自己那一片,然后被销毁 |
| 删除分支 | branch-env.yml → scripts/env down | 兜底:手动拉起、从来没开过 PR 的分支;仓库设置 delete branch on merge 让合并也触发它 |
| 向其他任何分支 push | 什么都不做 | 备份用的 push 或一个 spike,在有人想看之前不花一分钱 |
向 main 的 pull request | migrations-check.yml | 合入 main 后迁移图只有一个叶子;从空库能应用完整链条 |
push v* 标签 | release.yml | 由标签生成 staging 环境;评审人批准后把同一镜像晋升到生产并销毁 staging |
| 每晚 02:00 | sweep-envs.yml → scripts/sweep-envs | 销毁分支已不存在或闲置一周的一切 |
标签、push 与 delete 工作流#
# .github/workflows/branch-env.yml
name: branch environment
on:
  pull_request:
    types: [labeled, unlabeled, synchronize, closed]
  delete:
  workflow_dispatch:
    inputs:
      branch:
        description: branch to bring up without a PR
        required: true

concurrency:
  group: env-${{ github.head_ref || github.event.ref || inputs.branch }}
  cancel-in-progress: true

env:
  FLY_API_TOKEN: ${{ secrets.FLY_PREVIEW_TOKEN }}        # org-scoped deploy token; a separate preview org keeps it away from prod
  PREVIEW_PG_PASSWORD: ${{ secrets.PREVIEW_PG_PASSWORD }}
  PREVIEW_REDIS_URL: ${{ secrets.PREVIEW_REDIS_URL }}
  PREVIEW_BUCKET: ${{ vars.PREVIEW_BUCKET }}
  PREVIEW_AWS_ACCESS_KEY_ID: ${{ secrets.PREVIEW_AWS_ACCESS_KEY_ID }}
  PREVIEW_AWS_SECRET_ACCESS_KEY: ${{ secrets.PREVIEW_AWS_SECRET_ACCESS_KEY }}

jobs:
  up:
    # the gate: a PR carrying the `env` label, or someone asking for a branch by hand
    if: >-
      github.event_name == 'workflow_dispatch' ||
      (github.event_name == 'pull_request' && github.event.action != 'closed'
        && contains(github.event.pull_request.labels.*.name, 'env'))
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
        with:
          ref: ${{ github.head_ref || inputs.branch }}
      - uses: superfly/flyctl-actions/setup-flyctl@master
      - id: env
        env:
          BRANCH: ${{ github.head_ref || inputs.branch }}
        run: |
          scripts/env up
          echo "url=$(scripts/env url)" >> "$GITHUB_OUTPUT"
      - if: github.event_name == 'pull_request'
        uses: marocchino/sticky-pull-request-comment@v2
        with:
          header: env
          message: |
            Branch environment: ${{ steps.env.outputs.url }}
            Commit: `${{ github.event.pull_request.head.sha }}` · `/api/version/` says what it is running.

  down:
    # label removed, labelled PR closed or merged, or the branch itself deleted
    if: >-
      (github.event_name == 'pull_request' &&
        ((github.event.action == 'closed' && contains(github.event.pull_request.labels.*.name, 'env')) ||
         (github.event.action == 'unlabeled' && github.event.label.name == 'env'))) ||
      (github.event_name == 'delete' && github.event.ref_type == 'branch')
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: superfly/flyctl-actions/setup-flyctl@master
      - run: BRANCH="${{ github.head_ref || github.event.ref }}" scripts/env down
闸门是 env 标签,这也是我最想据理力争的部分。没有闸门,每个分支都要花掉一个应用和一份数据库克隆:某人为了备份笔记本而 push 的分支、明天就会被 squash 的 spike、机器人凌晨三点开的依赖升级。所以光 push 什么都不发生,光开 PR 也什么都不发生。给 PR 加上 env,环境就起来;标签在的时候每次 push 都更新它;移除标签、关闭 PR 或合并,它就下线。选择加入仍然是一个 GitHub 事件,而不是向某个人提请求,而且这一下点击是由唯一知道有没有人要看的那个人做的。置顶评论就是用户界面:给 PR 打标签,一条带 URL 的评论出现,可以发给任何人,而且每次 push 都在原地更新,不会堆叠。还没有 PR 就想拉起来的分支交给 workflow_dispatch,其余的交给笔记本上的 ./scripts/env up。
还有两种闸门值得知道。分支名过滤(branches: ['feature/**', 'fix/**'])不需要 PR,但每个功能分支都要付钱。“所有非草稿 PR"最自动,如果你的团队开 PR 开得晚、只在准备好时才开,那是正确的选择。我选标签,是因为它把花不花钱的决定交给了有上下文的人,也因为它可以收回而不用关掉任何东西。一个我喜欢的副作用:来自 fork 的 pull_request 运行拿不到 secrets,所以 fork 拉不起环境。
concurrency 比看起来更重要。对同一分支的一连串快速 push 会取消之前的部署而不是让它们赛跑;对同一应用同时跑两个 fly deploy,结局是其中一个输掉。
有过 PR 的东西,不管合没合并,拆除都由 closed 负责。delete 事件是给用 workflow_dispatch 拉起来、最终也没开 PR 的分支兜底的,而它只在分支真的被删除时才触发。那是一个仓库设置,Automatically delete head branches,默认关闭。打开之后,点 Merge 会关闭 PR 并删除分支,两个事件中的任何一个单独都会跑 env down。合并按钮就是拆除。
gh api -X PATCH repos/jaredlynskey/koreapost -f delete_branch_on_merge=trueFLY_PREVIEW_TOKEN 是这个文件里危险的一行。它能创建和销毁应用,如果 $APP 变成了分支环境之外的任何东西,它就能销毁生产。两道防护,我两道都留着:令牌限定在一个单独的 Fly 组织里,从字面上就看不到生产组织(演示里为了省去给新组织绑定账单的步骤,我用了生产组织 korea-post,只靠第二道防护);以及 down() 拒绝任何不匹配 slug-hash 模式的应用名。
分支环境无法替自己做的检查#
一个分支只看得见自己的迁移,所以真正要紧的检查跑在 pull request 上,针对合入 main 之后的状态,也是 main 要求的唯一状态检查:
# .github/workflows/migrations-check.yml
name: migrations
on:
  pull_request:
    branches: [main]

jobs:
  check:
    runs-on: ubuntu-latest
    services:
      postgres:
        image: postgres:18
        env: { POSTGRES_PASSWORD: ci, POSTGRES_DB: ci }
        ports: ['5432:5432']
        options: --health-cmd pg_isready --health-interval 5s --health-timeout 5s --health-retries 10
    env:
      DATABASE_URL: postgres://postgres:ci@localhost:5432/ci
      DEBUG: 'False'
      SECRET_KEY: ci-only
    steps:
      - uses: actions/checkout@v4
        with: { fetch-depth: 0 }
      - uses: astral-sh/setup-uv@v4
      - run: uv sync --frozen
      - name: Merge main into the branch (a conflict here fails the check too)
        run: |
          git config user.email [email protected] && git config user.name ci
          git merge --no-edit origin/main
      - name: One leaf in the migration graph
        run: |
          uv run manage.py makemigrations --check --dry-run
          uv run manage.py migrate --plan > /dev/null
      - name: The full chain applies from nothing
        run: uv run manage.py migrate --noinput
三十秒。正是它把 0114 / 0114 的碰撞从发布日的意外变成了第二个开发者 PR 上的一个红叉;下面的迁移一节会展示它真的触发。
main 上的规则#
如果分支能活一个月,或者有人直接往 main 上 push,上面的一切都撑不住。这些规则与其说是保护,不如说是为了让环境保持小、让迁移保持新:
main受保护且随时可部署。 只通过 PR 合并,且migrations检查针对当前的main是绿的(严格状态检查,所以上周绿过的 PR 在main前进后要重跑)。线性历史,禁止 force-push,禁止删除。- 功能分支要短。 开了两周的分支,环境落后
main两周,迁移和别人碰撞的概率也多了两周。一个月的功能藏在开关后面分块合入main。长寿的是开关,不是分支。 - 一个分支,一个环境,一个数据库。 命名已经强制了。
- 只有发布标签能上生产。 镜像从标签构建一次;staging 和生产跑的是那个镜像,不重新构建。
- 动了
migrations/的 PR 由另外两人之一评审。 见下文。
写成规则集,用 gh api -X POST repos/…/rulesets --input infra/github-ruleset-main.json 应用一次:
{
  "name": "main", "target": "branch", "enforcement": "active",
  "conditions": { "ref_name": { "include": ["~DEFAULT_BRANCH"], "exclude": [] } },
  "rules": [
    { "type": "deletion" },
    { "type": "non_fast_forward" },
    { "type": "required_linear_history" },
    { "type": "pull_request",
      "parameters": { "required_approving_review_count": 1, "dismiss_stale_reviews_on_push": true,
                      "required_review_thread_resolution": true } },
    { "type": "required_status_checks",
      "parameters": { "strict_required_status_checks_policy": true,
                      "required_status_checks": [ { "context": "check" } ] } }
  ]
}
一个诚实的褶皱。这个仓库是 GitHub Free 计划下的私有仓库,而在 Free 上,分支保护和规则集只对公开仓库可用;API 的回答是 403 Upgrade to GitHub Pro or make this repository public。delete_branch_on_merge 设置、environment 和工作流在 Free 上都能用。所以对于私有 Free 仓库上的小团队,上面的规则集是一种约定:migrations 工作流照样跑、照样变红,但没有东西会把合并按钮变灰。这是一个每月 4 美元的决定,我会在第二个人能合并的那一刻就做。
没有 develop 分支,没有 release/* 分支。Git-flow 的设计前提是集成昂贵、必须成批做。分支环境让集成变得便宜,成批的必要就消失了。
Staging 是标签的环境,生产是一次晋升#
Staging 复用整套机制。main 上的一个 v* 标签用分支名 staging/v1.42.0 运行 scripts/env up,命名把它变成 staging-v1-42-0-<hash>:同样从模板克隆的数据库,同样闲置即 suspend 的机器,同样的主机名方案。区别在于之后发生的事:
# .github/workflows/release.yml (abridged)
on:
  push:
    tags: ['v*']
jobs:
  staging:
    steps:
      - run: BRANCH="staging/${GITHUB_REF_NAME}" scripts/env up
      - run: echo "image=$(fly image show -a "maru-$(BRANCH=staging/$GITHUB_REF_NAME scripts/env name)" --json | jq -r '…')" >> "$GITHUB_OUTPUT"
  production:
    needs: staging
    environment: production        # required reviewer on this environment = the promotion gate
    steps:
      - run: fly deploy --config fly.api.toml --image "${{ needs.staging.outputs.image }}"
      - run: fly deploy --config fly.ws.toml  --image "${{ needs.staging.outputs.image }}"
      - run: BRANCH="staging/${GITHUB_REF_NAME}" scripts/env down
production 作业等待一个设有必要评审人的 GitHub environment。有人看过 staging,点 Approve,生产就按引用收到 staging 跑过的同一个镜像,不是重新构建。最后一步销毁 staging,因为它的任务完成了。如果没人批准,发布候选就是被否了,而当它的"分支”(staging/v1.42.0 从未在 origin 上存在过)通不过存活检查时,清扫器会把 staging 清掉。没有清扫器能核实的理由,任何东西都不许存在。
每晚的清扫器#
# .github/workflows/sweep-envs.yml
on:
  schedule:
    - cron: '0 14 * * *'     # 02:00 NZST
  workflow_dispatch:
jobs:
  sweep:
    steps:
      - uses: actions/checkout@v4
        with: { fetch-depth: 0 }
      - uses: superfly/flyctl-actions/setup-flyctl@master
      - run: scripts/sweep-envs
fetch-depth: 0 是因为清扫器需要每个远程分支及其最后提交日期,而不是 Actions 默认检出的那一个提交。workflow_dispatch 是为了事故之后能手工跑一次。
开发者实际要做的事#
push 一个分支,开 PR,想让人看的时候打上 env 标签。清单就这么长。三分钟内 PR 上出现一个 URL,每次 push 更新,PR 合并或关闭后消失。如果和队友撞了,迁移检查会比任何人都先告诉他们。没人去抢 staging,因为没有 staging 可抢;没人去拆任何东西,因为合并就是拆除。
而搭起这套东西的人,之后要为每个分支做什么?什么都不用。共享的 Postgres、Redis 和 bucket 开通一次,密钥放进 Actions 一次,此后反复要做的事只剩周一看一眼清扫器的日志。没有工单队列,没有要喊的机器人,没有要提示的对象。
不信任拆除的拆除#
env down 是常规情况,有意思的地方在于谁来清理。Redis 键和 Tigris 对象属于共享服务,而跑 down 的笔记本两者的凭据都不需要,因为环境自己的机器已经有了,也已经知道自己的前缀。所以 down 先把 suspend 的机器唤醒,在上面运行 manage.py env_teardown,然后才销毁应用、删除数据库。环境自己收拾自己:
$ BRANCH=feature/profile-website ./scripts/env down
== feature/profile-website -> feature-profile-webs-dcb2e7 (destroying)
redis: deleted 0 keys under feature-profile-webs-dcb2e7:*
tigris: deleted 278 objects under maru-preview/feature-profile-webs-dcb2e7/
Destroyed app maru-feature-profile-webs-dcb2e7
DROP DATABASE
destroyed feature-profile-webs-dcb2e7

$ curl -s -o /dev/null -w '%{http_code}\n' https://feature-profile-webs-dcb2e7-dev.marucommunity.com/api/version/
530
那个 530 再次印证了关于协调的那一点:Worker 仍在路由这个主机名,Fly 那边什么都没有,而没有人需要通知 Cloudflare。
env_teardown 没有 ENV_NAME 就拒绝运行,因为前缀为空时它会把整个共享 bucket 清空。这道防护就是这条命令作为一条命令、而不是 shell 脚本里三行代码存在的全部理由。
环境照样会泄漏。GitHub Actions 故障期间有分支被删除。开发者为了做个试验在笔记本上跑了 env up,从来没 push。fly apps destroy 偶发失败,被 || true 吞掉。三个月后有四十个应用,和一张让人问"发生了什么"的账单。
所以有第二道机制,它不信任第一道:上表里那个每晚的清扫器。它列出所有 maru-* 应用,弄清每个属于哪个分支,销毁分支已不存在或七天没有 push 的那些。闲置一周的分支不需要一个活着的 URL;下一次 push 两分钟就把它重建出来。哈希不可逆,所以清扫器为每个活着的分支算出环境名,销毁不在这个集合里的所有应用,再删掉后面没有应用的任何 env_* 数据库:
#!/usr/bin/env bash
# scripts/sweep-envs — nightly
set -euo pipefail
cd "$(git rev-parse --show-toplevel)"
[[ -f .env.preview ]] && { set -a; source .env.preview; set +a; }
ORG=${PREVIEW_ORG:-korea-post}; TTL_DAYS=${TTL_DAYS:-7}
cutoff=$(( $(date +%s) - TTL_DAYS*86400 ))

git fetch --prune --quiet origin
live=""
while IFS=$'\t' read -r ts branch; do
  [[ "$branch" == "main" ]] && continue
  (( ts >= cutoff )) || continue
  live+="$(BRANCH="$branch" scripts/env name)"$'\n'
done < <(git for-each-ref --format='%(committerdate:unix)%09%(refname:short)' refs/remotes/origin | sed 's#^\([0-9]*\)\torigin/#\1\t#')

apps=$(fly apps list --org "$ORG" --json | grep -o '"Name": *"maru-[^"]*"' | cut -d'"' -f4)
for app in $apps; do
  env="${app#maru-}"
  [[ "$env" =~ ^[a-z0-9-]+-[0-9a-f]{6}$ ]] || continue       # not a branch environment (e.g. maru-preview-pg)
  grep -qx "$env" <<<"$live" && continue
  echo "sweeping $app: branch gone or idle > ${TTL_DAYS}d"
  ENV_OVERRIDE="$env" scripts/env down || true
done
# ...then any env_* database with no app: DROP DATABASE.
演示的分支从来没 push 过(就是上面那次笔记本上的运行),所以在清扫器看来它们全都不存在了;有人从笔记本上拉起来、之后再也没 push 的 spike,一周后正是这个状态。它把剩下的两个拆了,包括 tagline 环境写下的 Redis 键:
$ ./scripts/sweep-envs
sweeping maru-feature-branch-envir-c65cb4: branch gone or idle > 7d
redis: deleted 0 keys under feature-branch-envir-c65cb4:*
tigris: deleted 322 objects under maru-preview/feature-branch-envir-c65cb4/
Destroyed app maru-feature-branch-envir-c65cb4
DROP DATABASE
sweeping maru-feature-profile-tagl-fa8832: branch gone or idle > 7d
redis: deleted 3 keys under feature-profile-tagl-fa8832:*
tigris: deleted 278 objects under maru-preview/feature-profile-tagl-fa8832/
Destroyed app maru-feature-profile-tagl-fa8832
DROP DATABASE

$ fly apps list --org korea-post | grep maru-
 maru-preview-pg │ korea-post │ deployed
(一件小事咬了我一口:macOS 自带的是 bash 3,没有关联数组。清扫器的第一版用了关联数组,在我的笔记本上死在 declare -A 上。上面这版用换行分隔的列表,在哪儿都能跑。)
费用是令人愉快的部分。suspend 的机器只付 rootfs,每月几美分。数据库是已经付过钱的卷上的 19 MB。Redis 是 Upstash 的按量付费,每十万条命令 20 美分,在分支测试的量级上四舍五入等于零。Tigris 前缀按存了多少付。共享 Postgres 节点是唯一的固定项,每月约两美元。二十个活跃分支的花费大致等于一台常开的 shared-cpu-1x,而清扫器把它维持在二十而不是两百。整个演示——三个环境一小时,加上共享部件——比我期间喝的咖啡还便宜。
跨分支的迁移,没有共享数据库来预警#
当每个开发者端到端负责一个功能时,每个分支里都有一个迁移。这让本节成为重要的一节。
离开共享环境世界时,人们会漏掉一件事。所有人都往同一个 dev 数据库部署时,迁移冲突会立刻、痛苦地浮现,但它们浮现了。一个迁移跑了,下一次部署失败了,有人当天下午修好。每个分支一个数据库之后,每个迁移在自己的环境里都完美运行,两个迁移第一次相遇是在第二个合入 main 的时候。做得不小心,冲突就从便宜的 dev 挪到了不便宜的发布。
四条规则,全都能由 CI 强制,所以没人需要记住它们。
1. 针对合入 main 后的状态,迁移图有两个叶子时 CI 失败。 makemigrations --check 能抓到模型和迁移不一致,但要紧的冲突是两个分支都加了 0042_*。要对着合入 main 的分支检查,而不是分支本身:
git fetch origin main
git merge --no-commit --no-ff origin/main || { echo "merge conflict"; exit 1; }
python manage.py makemigrations --check --dry-run
python manage.py migrate --plan 2>&1 | grep -q "Conflicting migrations" && exit 1这一个是我故意让它发生的。三个演示分支里有两个,feature/profile-tagline 和 feature/profile-website,各用一个迁移给 UserProfile 加了一个字段,每个环境在启动时应用了自己的。列只出现在该出现的地方:
env_feature_branch_envir_c65cb4      pending_email
env_feature_profile_tagl_fa8832      pending_email, tagline
env_feature_profile_webs_dcb2e7      pending_email, website
两个迁移都是 0114_*。两个分支互相看不见对方的,所以两个环境都不会告诉你有问题。把一个合入另一个,检查就会说:
$ git merge --no-commit --no-ff feature/profile-tagline
$ python manage.py makemigrations --check --dry-run
CommandError: Conflicting migrations detected; multiple leaf nodes in the migration graph:
  (0114_userprofile_tagline, 0114_userprofile_website in marketplace).
To fix them run 'python manage.py makemigrations --merge'

$ python manage.py makemigrations --merge --noinput
Created new merge migration marketplace/migrations/0115_merge_20260919_0324.py
    dependencies = [
        ('marketplace', '0114_userprofile_tagline'),
        ('marketplace', '0114_userprofile_website'),
    ]
第二位作者在自己的分支上、自己的环境里、不打扰任何人地运行那个 --merge,下一次 env up 就把 0115 叠加到他们的克隆上。(这个例子里 git 还先报了文本冲突,因为两个字段加在了模型文件的同一行。很真实,而且值得知道:文本冲突在解决之前会遮住迁移冲突。)
2. 迁移要向后兼容上一个发布的代码。 部署过程中有一个新 schema 与旧代码共存的窗口,机器回滚时则反过来。加列要可空或带默认值,绝不一步改名,绝不删掉当前发布仍在读的东西:先加,部署,回填,切代码,在后续发布里再删。expand and contract。它在这里更重要的原因是,一次性环境让部署更频繁,你待在那个窗口里的时间更多。按标签的 staging 就是彩排它的地方。
3. CI 还会往空数据库里从零迁移。 模板克隆测试的是"我的迁移能不能应用在真实数据上”。空库运行测试的是"整条链从零还能不能跑通”,能抓到那种假定前一个数据迁移已经填了什么的迁移。三十秒,抓住一类否则要等到下一台新笔记本才暴露的 bug。
4. schema 变更要有第二双眼睛。 小团队不需要 CODEOWNERS 文件,但需要一条规则:动了 migrations/ 的 PR 合并前由一位队友评审,而评审人的工作不是检查 SQL。是知道自己或团队里的其他人这两周是否在动同一张表,并把它说出来。超过十来个开发者,这份知识就装不进一个人的脑袋了,那时给 migrations/ 加一条 CODEOWNERS 才算物有所值。没有任何工具能替代这一点。机械性的东西工具都抓了,这就是件两分钟的活,也是旧共享环境世界里唯一值得保留的部分:两个人发现自己即将相撞的那一刻。
版本标识,让 URL 说出它在跑什么#
只有一个共享环境时,“staging 上是什么"是个 Slack 问题。有很多个时,它必须是环境的属性,否则每个 bug 报告都从考古开始。
- 每个镜像携带提交 SHA,应用把它暴露出来。
fly deploy --build-arg GIT_SHA=... --build-arg GIT_BRANCH=...把它们作为环境变量烙进镜像,/api/version/连同环境名、Fly 应用和镜像引用一起返回(见上面的截图)。听到"feature-profile-tagl-fa8832 上坏了”,任何人第一件事就是确认它跑的是自己以为的那个提交。第一个演示环境是在工具提交之前一个提交的工作树上部署的,端点如实说了:是87c061b9,不是我预期的 SHA。 ENVIRONMENT=$ENV在每一行日志和 Sentry 标签里。 分支的错误不会污染生产的错误追踪,一键就能过滤。- 分支有 SHA,发布有标签。
feature-payments-retr-3f9a1c永远没有版本号;它有提交。staging 和生产有v1.42.0。 - 移动端携带的是最低 API 版本,不是 URL。 开发菜单里的 URL 字段是测试人员把真机指向某个分支的方式,带有 API schema 版本的
/version端点则是应用判断对方是否可理解的方式。
这解决不了什么#
它解决不了只有放在一起才有意义的两个功能。分支环境展示一个分支。答案是把两者都藏在开关后面合入 main,然后看 main,可以用一个跟随 main 的常驻环境(main-dev.marucommunity.com,每次合并重新部署)来做。这是我唯一会保留的长期非生产环境,没人往它上部署;它是用来看下一个发布会是什么样的。
它解决不了那些要求注册回调、又不接受通配符的提供商。Firebase Auth 接受父域名,所以 marucommunity.com 覆盖所有 -dev 分支主机名。有些 OAuth 和支付提供商不接受,那就保留一个共享主机名,由 Worker 路由到最后认领它的那个环境。那是一把小锁,锁在一件小事上,比把一切都锁住好得多。
它解决不了迁移的人的一面。工具抓的是机械性冲突。它抓不到你们两个在同一个两周里以互不兼容的方式建模同一个概念,唯一的补救是那次有人注意到的迁移评审。
我会在你的环境里检查什么#
如果你有共享的 dev 或 staging,还有一条预约它的 Slack 线程:
- 一个做完的分支,要等多久才能让作者以外的人看到它在运行?超过一小时,你就在用交付时间为这把锁付费,而在小团队里,那是团队里很大一部分人在等。
- 共享数据库多久重置一次,重置时谁丢了工作?
- 一个新开发者在第一天,能不能不向任何人要任何东西,就拿到一个跑着自己分支的公开 URL?无论他们得要的是什么,那就是最先该自动化的东西。
- 新环境是从真实数据开始的吗?如果从空库开始,它第一个抓不到的 bug 就是那个在空表上没事、在真表上要跑四十分钟的迁移。
- 你的非生产托管里,有没有什么东西在所有人都忘了它一个月后还会存在?有的话,先于一切写清扫器。泄漏从第一天就开始了。
那个 Slack 问题消失,不是因为人们不再问,而是因为答案永远是"在用啊,用我自己的。"