我做过的每一个图片上传功能,骨子里都有同一个矛盾。上传的人希望照片赶紧传上去。我希望服务器把图片压缩好、生成缩略图、算出 blurhash 和几个主色、去掉不该留在里面的元数据,再按应用其他部分期望的方式存起来。要把我这份清单做全,最省事的办法是让文件经过 API,而上传的人那份清单,恰恰就是被这一步拖慢的。
快的办法是预签名 URL。API 签出一个 URL,客户端把文件直接 PUT 进 bucket,字节完全不经过 API。它能成为标准答案是有道理的。可你一这么做,后端就被踢出了整个流程:它发出一个 URL,然后就什么都听不到了。文件到了吗?大小是预期的吗?它到底是不是 JPEG?总得有什么东西告诉后端,而常见的几个选项都有点让人叹气:相信客户端会回调一声"传好了"(客户端会撒谎、会崩溃、会断网),按计划轮询 bucket(又慢又浪费),或者等第一次读取时再懒处理(第一个看的人买单,而且你依然不知道文件什么时候才能放心引用)。这就是为什么直接上传到 S3 看起来比实际更难。上传本身很容易,缺的是信号。
对象通知就是这个信号。我在 Fly.io 上用的 S3 兼容存储 Tigris,每当 bucket 里有对象被创建或删除,都会向你的应用 POST 一小段 JSON。在 AWS 上对应的东西叫 S3 事件通知,但通常要先接上 Lambda、SQS 队列或者 EventBridge,事件才能到你的代码(SNS 倒是能直接向 HTTPS 端点 POST,可那样你得先确认订阅、再验证签名)。Tigris 把它压缩成一个发往你自己 URL 的 HTTP 请求,存储到后端的信号传递,大概没法比这更简单了。这个功能存在的意义,就是让 bucket 能直接跟你的后端说话,不用你在中间搭桥。
这篇文章讲完整个流程:怎么配置,接收事件的 Django 端点,服务端处理一步不少的预签名上传,以及几个坑(CORS、大小限制、过期、多文件)。最后再看同一个信号怎么干后台的活:日志文件一落进 bucket 就变成 Discord 告警,让我删掉了一个伺候了好几个月的 cron 任务。
简短的答案#
在 Tigris 控制台里打开 bucket,进 Settings,再进 Object notifications。填一个你应用上的 HTTPS URL,认证选 basic auth(一组用户名和密码,Tigris 会放在 Authorization 头里发过来;另一个选项是 bearer token)。再加一个过滤条件,只接收你关心的那些 key。过滤条件是一个类 SQL 的表达式,“只要这篇文章处理的那三个前缀"写出来是这样:
WHERE `key` REGEXP "^(uploads/raw|logs/api|media)/"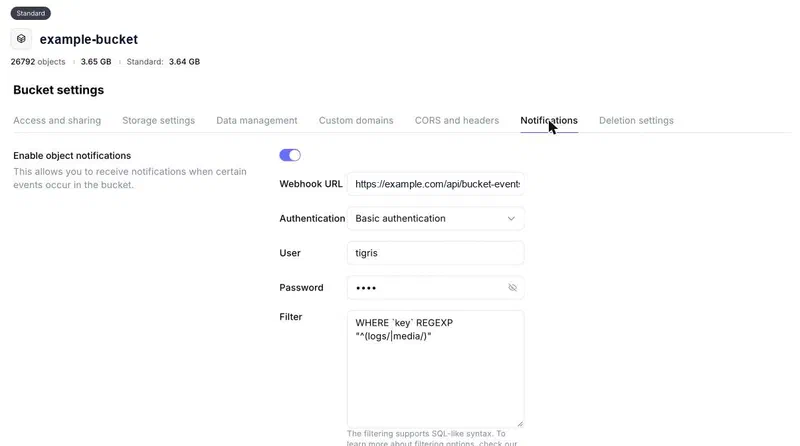
之后每有变化,Tigris 就会发来这样一批事件:
{
  "events": [
    {
      "eventName": "OBJECT_CREATED_PUT",
      "eventTime": "2026-11-07T09:12:44Z",
      "bucket": "example-bucket",
      "object": { "key": "uploads/raw/1f3c.jpg", "size": 48213, "eTag": "9b2c…" }
    }
  ]
}
你会遇到的事件名有 OBJECT_CREATED_PUT、OBJECT_CREATED_MULTIPART、OBJECT_CREATED_COPY 和 OBJECT_DELETED,另外还有重命名和存储层级变更。你的端点负责校验 auth,按 key 前缀把每个事件分发出去,然后在十秒内返回 2xx。有三件事最好一开始就考虑进去:投递是 at least once 的,所以你会收到重复;事件是成批发送的,所以一个请求里可能带着好几个;它们还可能乱序到达,所以别拿到达顺序去判断哪个是"最新”。
接收 bucket 事件的 Django webhook#
这个 view 是故意写得很无聊的。它校验 auth、解析请求体,然后把每个事件交给路由:
import base64, hmac, json, logging
from django.conf import settings
from django.http import JsonResponse
from django.views.decorators.csrf import csrf_exempt
from django.views.decorators.http import require_POST

from .bucket_events import handle, parse

logger = logging.getLogger(__name__)

def _authorised(request, secret) -> bool:
    header = request.headers.get("Authorization", "")
    if not header.startswith("Basic "):
        return False
    try:
        user, _, password = base64.b64decode(header[6:]).decode().partition(":")
    except (ValueError, UnicodeDecodeError):
        return False
    return hmac.compare_digest(user.encode(), b"tigris") and hmac.compare_digest(
        password.encode(), secret.encode()
    )

@csrf_exempt
@require_POST
def bucket_webhook(request):
    secret = settings.BUCKET_WEBHOOK_SECRET
    if not secret:
        return JsonResponse({"error": "not configured"}, status=503)
    if not _authorised(request, secret):
        return JsonResponse({"error": "unauthorised"}, status=401)
    try:
        body = json.loads(request.body or b"{}")
    except ValueError:
        return JsonResponse({"error": "invalid json"}, status=400)
    for event in parse(body):
        try:
            handle(event)
        except Exception:
            logger.exception("bucket event failed: %s", event.key)
    return JsonResponse({"ok": True})
compare_digest 的作用,是让校验不管收到什么都花同样的时间(要传 bytes,因为传字符串时它遇到非 ASCII 输入会直接抛异常,一个精心构造的头拿到的就是 500 而不是 401)。如果 secret 没有配置,比如在一台刚开出来的 staging 机器上,端点会拒绝所有请求,而不是放行所有请求。handler 抛了异常,会记一条日志,但照样回 200:Tigris 对一切非 2xx 的响应都会重试,重试撞上的还是同一个 bug,而且到那时事件已经被认领了(往下两节会讲),重试其实什么也干不了。真正让问题得到修复的,是那条日志。这里有个前提:失败得是确定性的。存储那边一次短暂的超时,会把这个事件永远消耗掉:照片无所谓,因为保存时可以自己处理;但日志文件的告警就丢了。如果你在意这一点,就在 except 里释放认领,然后回 500 让 Tigris 重试,并接受真正的 bug 会一直重试到修好为止。
按前缀路由#
bucket 里的东西本来就是按前缀组织的,所以按前缀路由最顺手。每种用途就是一个函数,加上表里的一行:
HANDLERS = [
    ("uploads/raw/",   on_raw_photo),
    ("logs/api/",      on_api_log_file),
    ("media/",         on_media_change),
]

def handle(event):
    for prefix, fn in HANDLERS:
        if event.key.startswith(prefix):
            if claim(event):  # 见下文
                fn(event)
            return
以后要加第四种用途,就是多一个函数、多一行。我比自己预想的还要喜欢这种写法。
At least once 的意思是"可能两次"#
端点响应慢或者返回错误时,Tigris 会重试,而且和大多数 webhook 发送方一样,它不保证每个事件你只会看到一次。所以在 handler 运行之前,先按 (key, eTag, eventName) 认领这个事件。eTag 很关键:文件被覆盖后就是一个新版本,eTag 也是新的,理应再处理一次;同一个版本的重复投递则不该再处理。
from django.core.cache import cache

def claim(event, ttl=7 * 24 * 3600) -> bool:
    k = f"bucket-event:{event.name}:{event.key}:{event.etag}"
    return cache.add(k, 1, ttl)  # 已经被别人认领就返回 False
cache.add 只在 key 不存在时才写入,这在 Redis 里是原子操作,所以两台机器收到同一次重试,不可能都抢到。实际项目里我用的是基于数据库的租约,因为我希望它在 Redis 被清空后还能留着,但思路完全一样。
图片直传 S3,处理流程一样不少#
前面那些管道活,值就值在这一部分。
以前,给一条帖子选照片时,应用会先把照片攥在手里,等你点了"发布",再把它们全部以 base64 发给 API。API 接着缩放尺寸、生成缩略图、算出主色和 blurhash,全部做完才回复。十张照片再碰上慢网速,那个转圈就转得很久。而且一个带着十张 base64 照片的请求,对 API 服务器来说是一个又大又慢、还得整个攥在内存里的请求体,这也是我一直悄悄把照片压得很小的真正原因。
现在变成了四步,而且每一步后端都知道。
1. 客户端先缩图,再申请一个槽位#
应用仍然会在设备上缩图,缩到服务器保留的最长边(1080px),存成质量 0.7 的 JPEG。这一步缩放只是为了省用户的流量,没有别的目的。然后它向 API 申请一个上传槽位:
import uuid
from datetime import timedelta
import boto3
from django.utils import timezone

s3 = boto3.client("s3", endpoint_url="https://fly.storage.tigris.dev")
BUCKET = "example-bucket"

def create_upload_slot(user):
    public_id = uuid.uuid4()
    key = f"uploads/raw/{public_id}.jpg"
    upload = PhotoUpload.objects.create(
        user=user,
        public_id=public_id,
        raw_key=key,
        expires_at=timezone.now() + timedelta(days=2),
    )
    url = s3.generate_presigned_url(
        "put_object",
        Params={"Bucket": BUCKET, "Key": key, "ContentType": "image/jpeg"},
        ExpiresIn=15 * 60,
    )
    return {
        "upload_id": str(upload.public_id),
        "url": url,
        "method": "PUT",
        "headers": {"Content-Type": "image/jpeg"},
        "expires_in": 15 * 60,
    }
槽位先是数据库里的一行,然后才是一个文件。正因为这样,服务器才知道是谁申请的、什么时候过期,以及后来它到底有没有被用过。
2. 客户端直接 PUT 到 bucket#
const slot = await api.post("/photo-uploads/");
const res = await fetch(slot.url, {
  method: slot.method,
  headers: slot.headers,
  body: blob,
});
if (!res.ok) throw new Error("upload refused");
// 把 slot.upload_id 留着,保存时要用
API 从头到尾见不到这些字节。浏览器、React Native 或原生应用都是同一套做法;唯一的区别是浏览器需要在 bucket 上配一条 CORS 规则,这个放在下面的坑里讲。
3. Tigris 通知后端,处理流程跑起来#
几秒之内,Tigris 就会针对 uploads/raw/… 发来一个 OBJECT_CREATED_PUT,handler 跑的是 base64 路径一直在用的那套图片处理流程,而这时用户还在输入标题:
from io import BytesIO
from PIL import Image, ImageOps
from django.core.files.base import ContentFile
from django.utils import timezone
import blurhash

MAX_BYTES = 15 * 1024 * 1024

def on_raw_photo(event):
    if not event.name.startswith("OBJECT_CREATED"):
        return
    if event.size > MAX_BYTES:
        s3.delete_object(Bucket=event.bucket, Key=event.key)
        return
    upload = PhotoUpload.objects.filter(raw_key=event.key, processed_at=None).first()
    if upload is None:
        return
    data = s3.get_object(Bucket=event.bucket, Key=event.key)["Body"].read()
    process(upload, data)

def to_webp(im, longest, quality):
    im = im.copy()
    im.thumbnail((longest, longest))
    buf = BytesIO()
    im.save(buf, "WEBP", quality=quality, icc_profile=im.info.get("icc_profile"))
    return ContentFile(buf.getvalue())

def process(upload, data):
    with Image.open(BytesIO(data)) as im:
        im = ImageOps.exif_transpose(im).convert("RGB")
        im.thumbnail((1080, 1080))
        upload.width, upload.height = im.size
        upload.dominant_color = "#%02x%02x%02x" % im.resize((1, 1)).getpixel((0, 0))
        upload.image.save(f"{upload.public_id}.webp", to_webp(im, 1080, 80), save=False)
        upload.thumbnail.save(f"{upload.public_id}_t.webp", to_webp(im, 320, 70), save=False)
        upload.blurhash = blurhash.encode(im.resize((32, 32)), 4, 3)
    upload.processed_at = timezone.now()
    upload.save()
on_raw_photo 的第一行比看上去重要。路由会把 uploads/raw/ 下的每一个事件都送到这里,包括孤儿清理和上面那个大小检查自己触发的删除,而对一个已经不在的 key 调 get_object,只会抛异常。
所以客户端那一步缩放,从头到尾只是为了传输。格式(WebP)、尺寸、缩略图、占位图,以及存下来的宽高,依然由服务器说了算。经 Pillow 重新编码还会顺手丢掉 EXIF 块,手机相机就是把 GPS 位置放在那里的,所以隐私清理是白送的。ICC 配置文件本来也会一起丢掉,那会让广色域的手机照片颜色稍微偏一点,所以 to_webp 把它原样带了过去。如果你更想保留像素级的原图,那就别在客户端缩;流程完全一样,只是 PUT 更大,而更大的 PUT 恰恰是这套设计让它变便宜的那件事。有一个坑:iPhone 的原图是 HEIC,Pillow 只有装了 pillow-heif 才打得开。
4. 保存时挂上照片,从不等 webhook#
用户点"发布"时,请求里带的是 upload_ids,而不是图片数据。服务器逐个查找,有三种结果:
def take(user, upload_ids):
    uploads = list(PhotoUpload.objects.filter(
        user=user, public_id__in=upload_ids, expires_at__gt=timezone.now()
    ))
    if len(uploads) != len(set(upload_ids)):     # 已过期,或不属于这个用户
        raise UploadNotReadyError(upload_ids)
    for upload in uploads:
        if upload.processed_at is None:          # webhook 还没到
            data = read_raw(upload)              # PUT 没落地就是 None
            if data is None:
                raise UploadNotReadyError(upload.public_id)
            process(upload, data)
    return uploads
如果通知已经跑过了,处理好的文件就原样挂上去。如果文件在 bucket 里,通知却还没到,保存就当场把它处理掉,所以发帖从来不用等 webhook。通知是抢跑,不是依赖。如果文件根本不在,或者某个 id 已经过期、属于别人,保存会返回一个校验错误,应用稍等一下再重试;应用在发送前会先等自己的 PUT 完成,所以实际上这种情况很少见。
让这套东西站得住的几个细节。槽位属于某个用户,所以服务器只接受同一个人创建的上传 id,不然任何看到 id 的人都能把你的照片挂到他自己的帖子上。处处都有退路:申请槽位失败、PUT 被拒,或者 API 是旧版本,应用就照老办法发 base64。只有当每张新照片都有槽位时它才走上传这条路,所以一条帖子的图片要么全是上传、要么全是 base64,顺序始终是同一份列表。孤儿会过期:有些人选了照片又放弃了,所以一直没被挂上的上传两天后过期,现有的孤立媒体清理任务会把它的文件清掉。
预签名 URL 上传的坑:CORS、大小限制、过期、多文件#
预签名上传出的问题,大多出在通知触发之前。下面这些,是我希望能在一页里看全的。
CORS,只有浏览器需要#
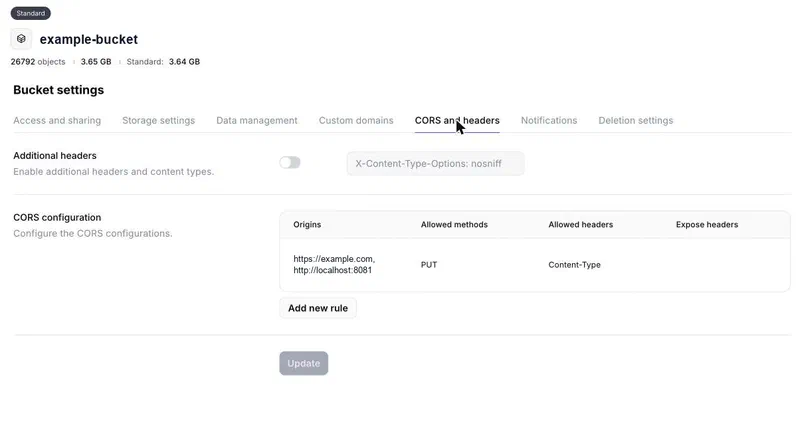
原生应用不在乎这个。浏览器在 PUT 之前会先向 bucket 发一个预检 OPTIONS,除非 bucket 的 CORS 规则允许来自你的源的 PUT 并带上 Content-Type 头,否则上传会以 CORS 错误告终。Tigris 用的是标准的 S3 CORS 配置,所以规则写法和 AWS 上一样。预签名 PUT 用 curl 能通、在页面上不行时,第一个要查的就是它。
Content-Type 是签名的一部分#
签名时带上 ContentType,意味着客户端必须原样发送这个头,否则 bucket 会回 403 SignatureDoesNotMatch。这就是槽位把 headers 和 URL 一起返回的原因。要有意识地签上它,但也要清楚它能换来什么:被强制的是头,不是内容,所以一个标着 image/jpeg 的 PDF 照样能进来。真正的检查在处理流程里;Pillow 拒绝打开不是图片的东西,那一行也就永远不会被标记为已处理。
大小限制#
预签名的 PUT URL 不带任何大小限制。如果你需要在字节落地之前就硬性拦住,用预签名 POST 配一个 content-length-range 策略条件可以做到。我没费这个劲,因为通知里带着对象的 size:handler 在读取之前先把超限的删掉,保存时那条路径最多只读上限加一个字节,够它判断就行。应用发的也就几百 KB;接近 15 MB 的东西,不会是我们的。
过期#
这里有两个时钟。预签名 URL 的有效期是十五分钟,做一次 PUT 绰绰有余,又短到泄露了也很快就没用。槽位那一行的有效期是两天,足够覆盖有人选好照片、把手机一放、第二天再把帖子写完的情况。客户端把挂了一天的待上传视为过期,直接重新申请一个,而不是抱着侥幸。
多个文件,以及更大的文件#
一个文件一个槽位。十张照片就是十个槽位、十个并行的 PUT,每一个都有自己的进度(XMLHttpRequest 有 upload.onprogress,fetch 没有),这是一个巨大的 base64 POST 给不了的。超过几 MB 就用分片上传(每个分片最小 5 MiB,所以它是给远大于这个数的文件准备的):在服务器上创建 multipart upload,给每个 upload_part 预签名,分片都到齐后再完成它。上传完成时 Tigris 会发 OBJECT_CREATED_MULTIPART,同一个 handler 照样触发,其他什么都不用改。
乱序#
事件可能乱序到达,因为对象可能写入了不止一个区域。对上传来说无所谓:一个 key,一个事件。对会被覆盖的 key,相信 eTag 和对象的 Last-Modified,别相信 webhook 到你这里的先后顺序。
同一个信号用在日志上:Discord 告警#
bucket 一旦能跟后端说话,任何落进去的东西都能用同样的方式响应,我把它指向的第二样东西就是日志。
应用的日志以 gzip 压缩的小文件形式送进 bucket,每个应用大约五分钟一个。今年大部分时间里,一个按 15 分钟 cron 跑的 GitHub Actions workflow 用 DuckDB 读归档里最近 20 分钟的数据,找出慢请求的行,再往 Discord 发一份汇总。纸面上没毛病。实际上,平台一忙,GitHub 的定时 workflow 就不会准点跑,于是"每 15 分钟"更像是"每隔几个小时",等它终于跑起来,要啃的时间窗口变大了,偶尔还会内存不足。我为了不让数据在两次运行之间漏掉而加的重叠窗口,又让同一个慢请求有时出现两次。就为了"请求慢了告诉我一声",搭了这么一大套机器。
现在每个日志文件在落地时读一次,只读一次。它们 gzip 之后也就几 KB。handler 把慢请求的行挑出来,如果数量够多,或者有一个特别慢的,就通过 webhook 往一个 Discord 频道发一份汇总。一个文件里突然冒出一堆 5xx 也同样处理。从 Python 调 Discord webhook 就是一次请求:
import requests
from django.conf import settings

def discord_alert(text: str) -> None:
    requests.post(
        settings.DISCORD_WEBHOOK_URL,
        json={"content": text[:1900]},  # Discord 单条消息上限 2000 字符
        timeout=5,
    )
没有 cron,没有重叠窗口,没有重复告警,而且告警会在请求发生后几分钟内到达,不用再等 GitHub 什么时候想起来。那个 Action 已经删了。
反正文件已经打开了,我顺便把里面的内容(错误、警告、健康检查)按小时计数,写进一张统计表。每日汇总以前要扫一整天的归档,现在只读几百行,只有统计出现缺口时才回头去扫归档。
给删除加一道防线#
这个是计划外的,有了 OBJECT_DELETED 事件之后自然就冒出来了。媒体文件被删除时,handler 会检查还有没有数据行指向它。如果有,那就是某处有 bug(或者有人在 bucket 控制台里手滑了),于是它清掉那一列,让应用显示占位图而不是一张裂开的图片,再把这事报告出来。
它还会按小时统计删除数量。正常的清理一小时也就删几个。要是哪天一小时里删了两三百个,我希望在事情发生的当下就知道,而不是等用户开始反馈照片变成空白。
值得知道的几件事#
响应要快。Tigris 给每次投递十秒。读一个 5 KB 的日志文件、处理一张手机照片都来得及;可能更久的活就丢进队列,view 直接返回 200,否则 Tigris 会超时重试,你又得回头去重。
在 bucket 那一层过滤。我的日志传送程序每个应用每隔几分钟就写一个文件,永不停歇。如果你只关心某一个前缀,就写进通知的过滤条件里,别让其他事情也把你的应用叫醒。
用假的请求体测试。payload 小而稳定,所以测试里直接带上正确的 Authorization 头,往 view 上 POST 一段 JSON,再断言 handler 做了什么。完全不用碰真实的存储。
别第一天就让它承重。这里的每一种用途都有后备方案:保存可以自己处理照片,每日汇总仍然可以扫描归档,应用仍然可以发 base64。通知让它们每一个都更快、更省,但哪个 webhook 丢了,也没有谁会因此倒下。
这周最爽的一刻,是删掉那个 workflow 文件。四十行 YAML、一个 Python 脚本、两个仓库 secret,外加隔三差五的一句"告警怎么没响",全都没了,取而代之的是一个 handler:文件到了,读一个小文件,完事。不过重点还是上传。照片以网络允许的最快速度传上去,服务器对每一张仍然握有最终决定权,而且没有人需要在 bucket 和后端之间搭一座桥,因为 bucket 现在会自己说发生了什么。